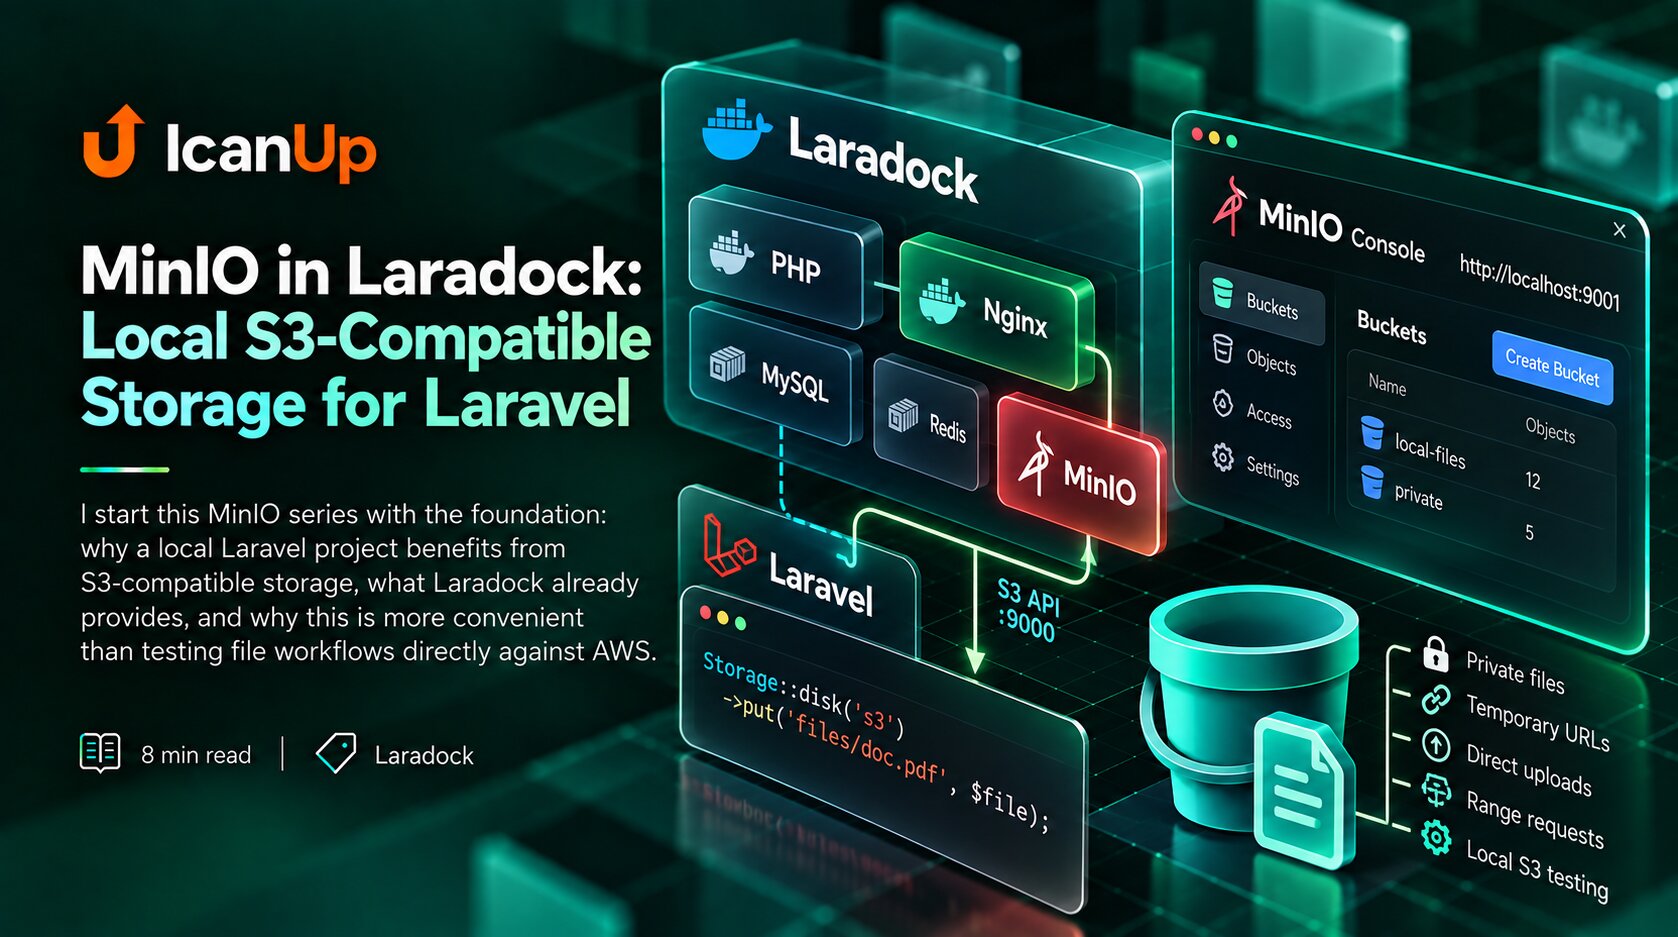
Починаю серію про MinIO з базового кроку: навіщо локальному Laravel-проєкту S3-сумісне сховище, що вже дає Laradock і чому це зручніше, ніж перевіряти роботу з файлами одразу на AWS.
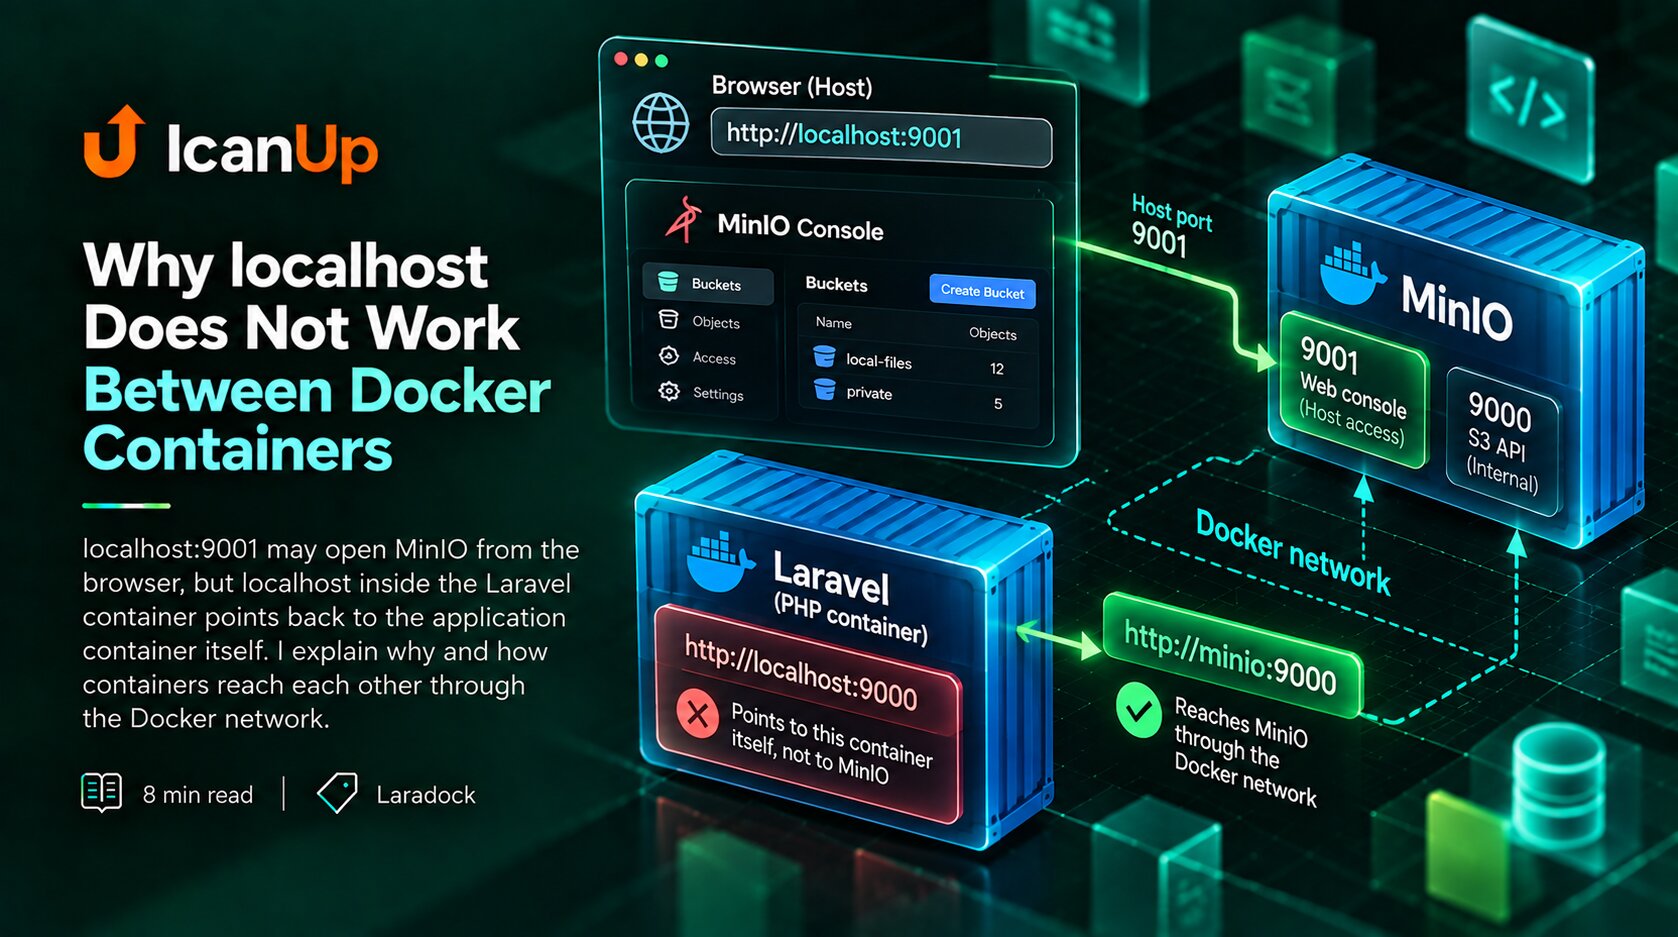
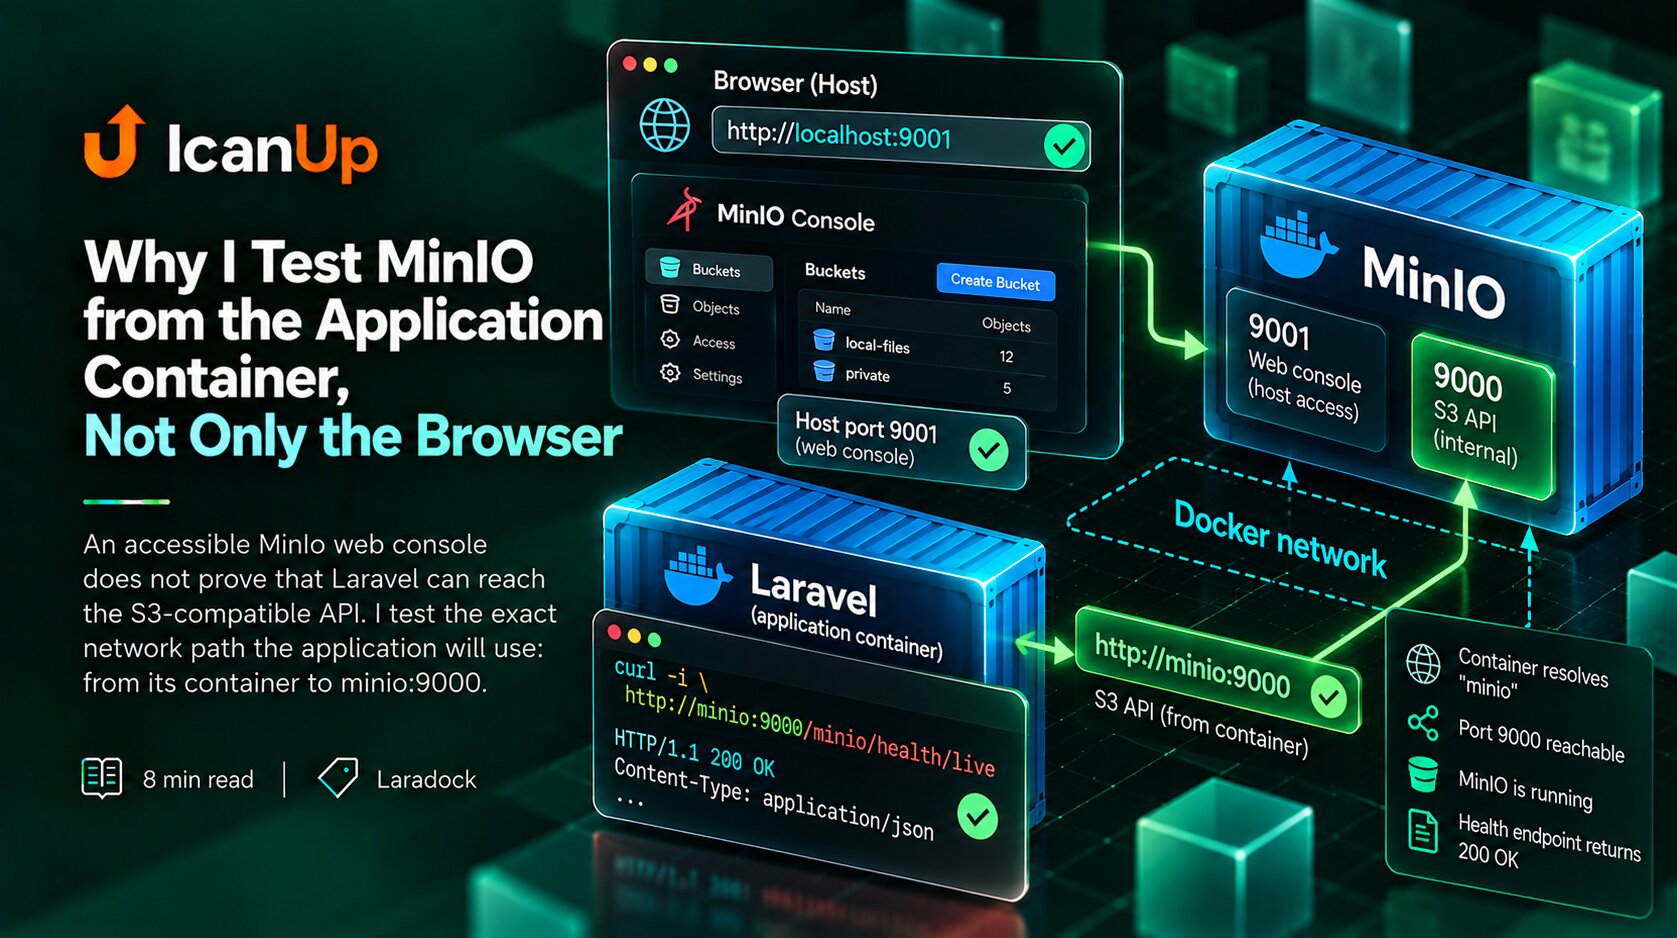
У браузері localhost:9001 може відкривати MinIO, але той самий localhost усередині Laravel-контейнера вже означає сам контейнер застосунку. Розбираю, чому так відбувається і як контейнери знаходять один одного через мережу Docker.
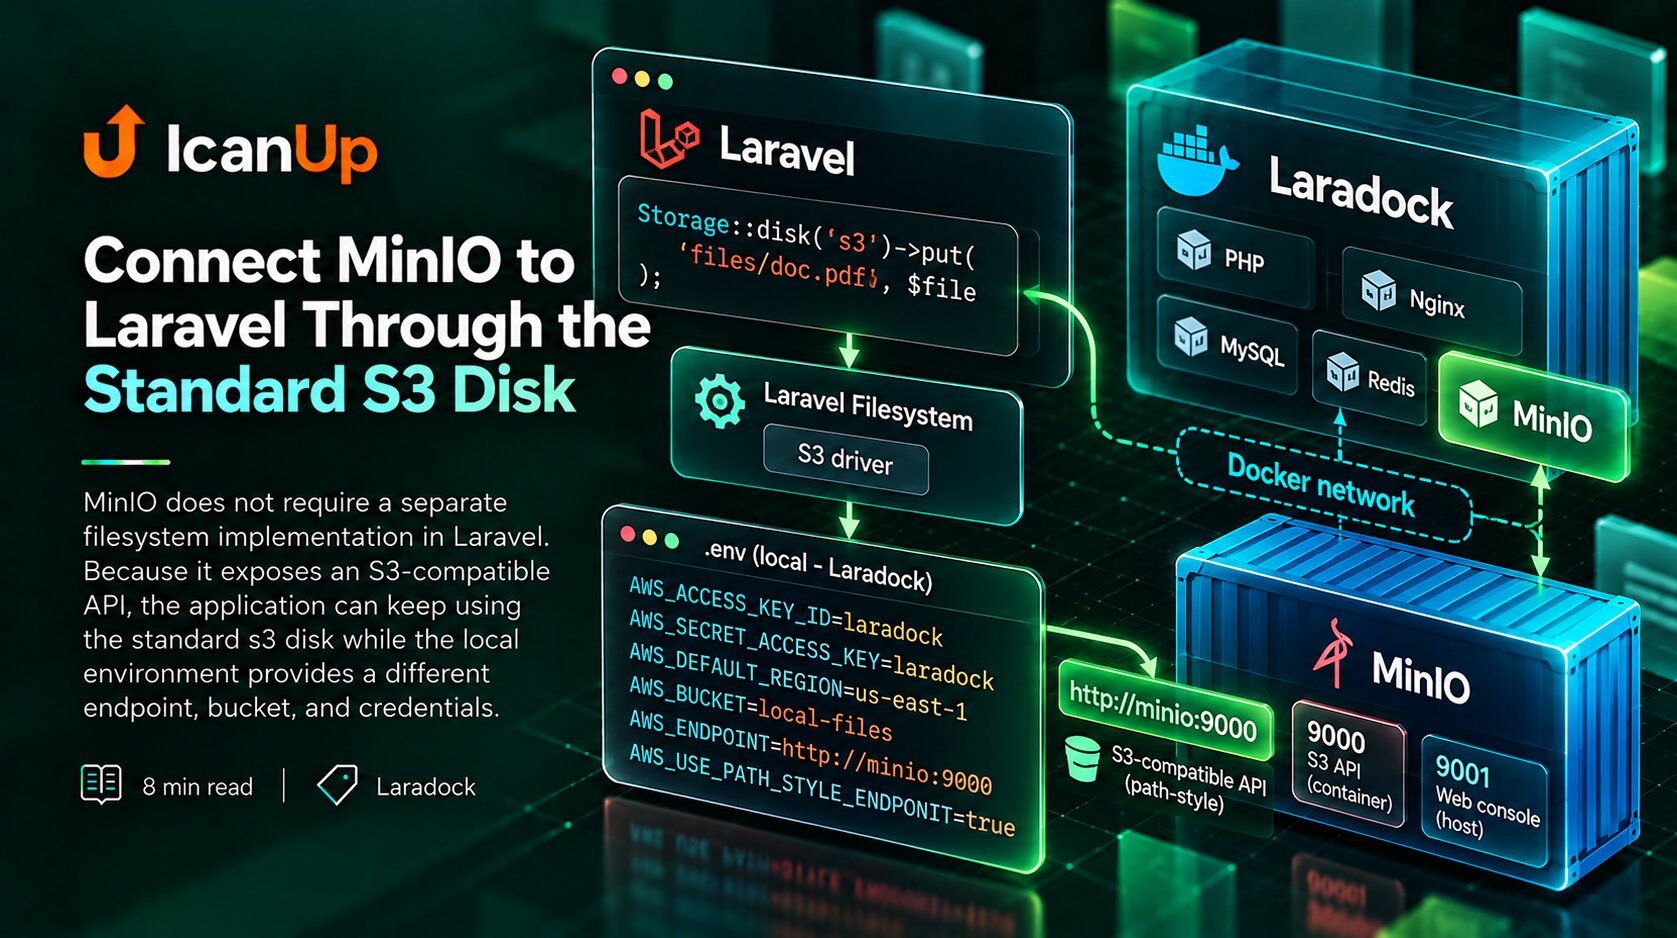
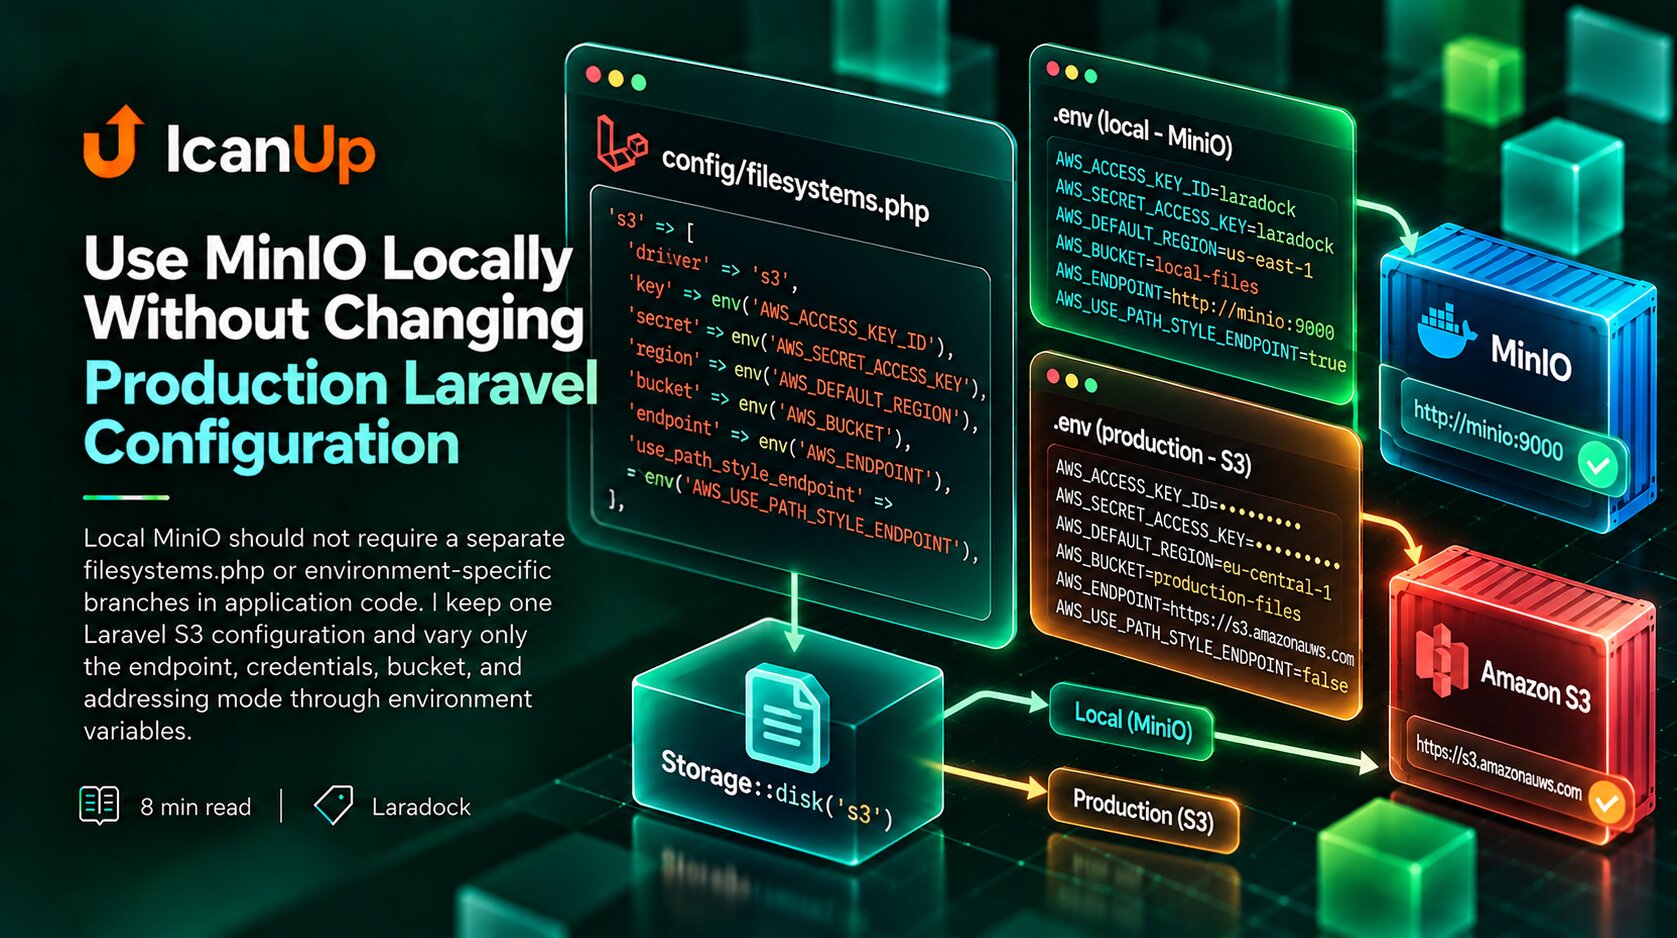
MinIO не потребує окремої файлової реалізації в Laravel. Якщо сховище підтримує S3-сумісний API, застосунок може залишитися на стандартному disk s3, а локальне середовище лише задає іншу адресу, бакет і облікові дані.
Локальний MinIO не повинен вимагати окремої версії filesystems.php або умов у коді. Я залишаю одну S3-конфігурацію Laravel для всіх середовищ, а адресу сховища, облікові дані, бакет і режим адресації задаю через змінні середовища.
Відкрита веб-консоль MinIO ще не доводить, що Laravel бачить S3-сумісний API. Я перевіряю саме той мережевий шлях, яким користуватиметься застосунок: від його контейнера до minio:9000.
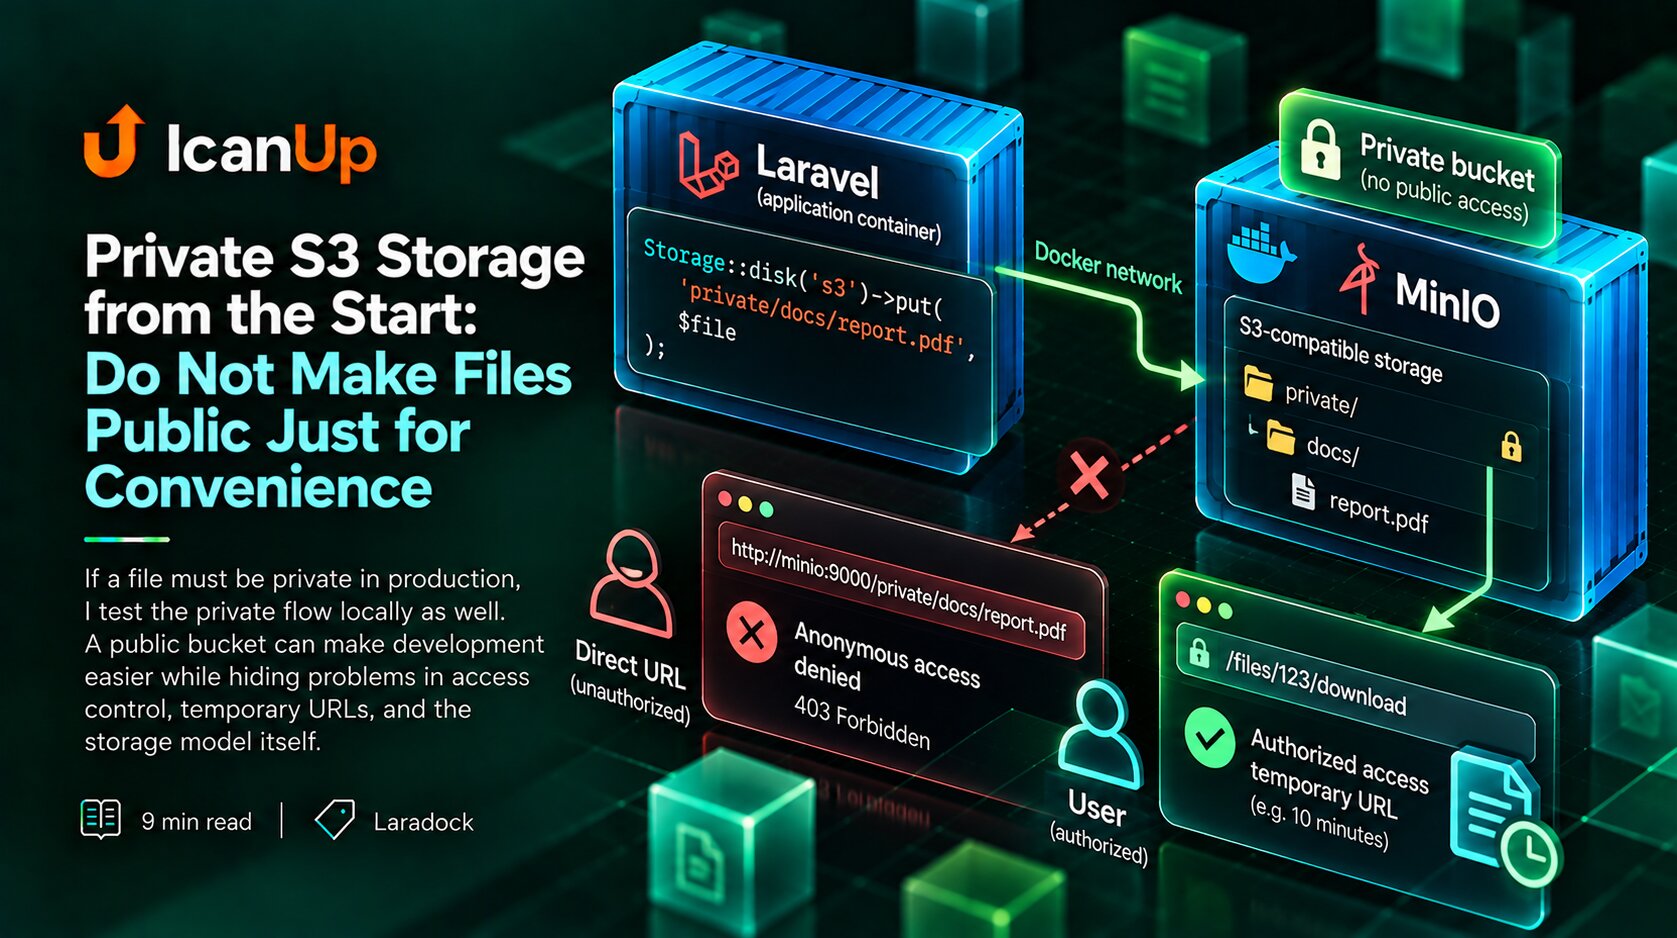
Якщо файл у production має бути приватним, локально я теж перевіряю приватний сценарій. Відкритий бакет може спростити розробку, але водночас приховати помилки в контролі доступу, тимчасових посиланнях і самій моделі роботи з файлами.
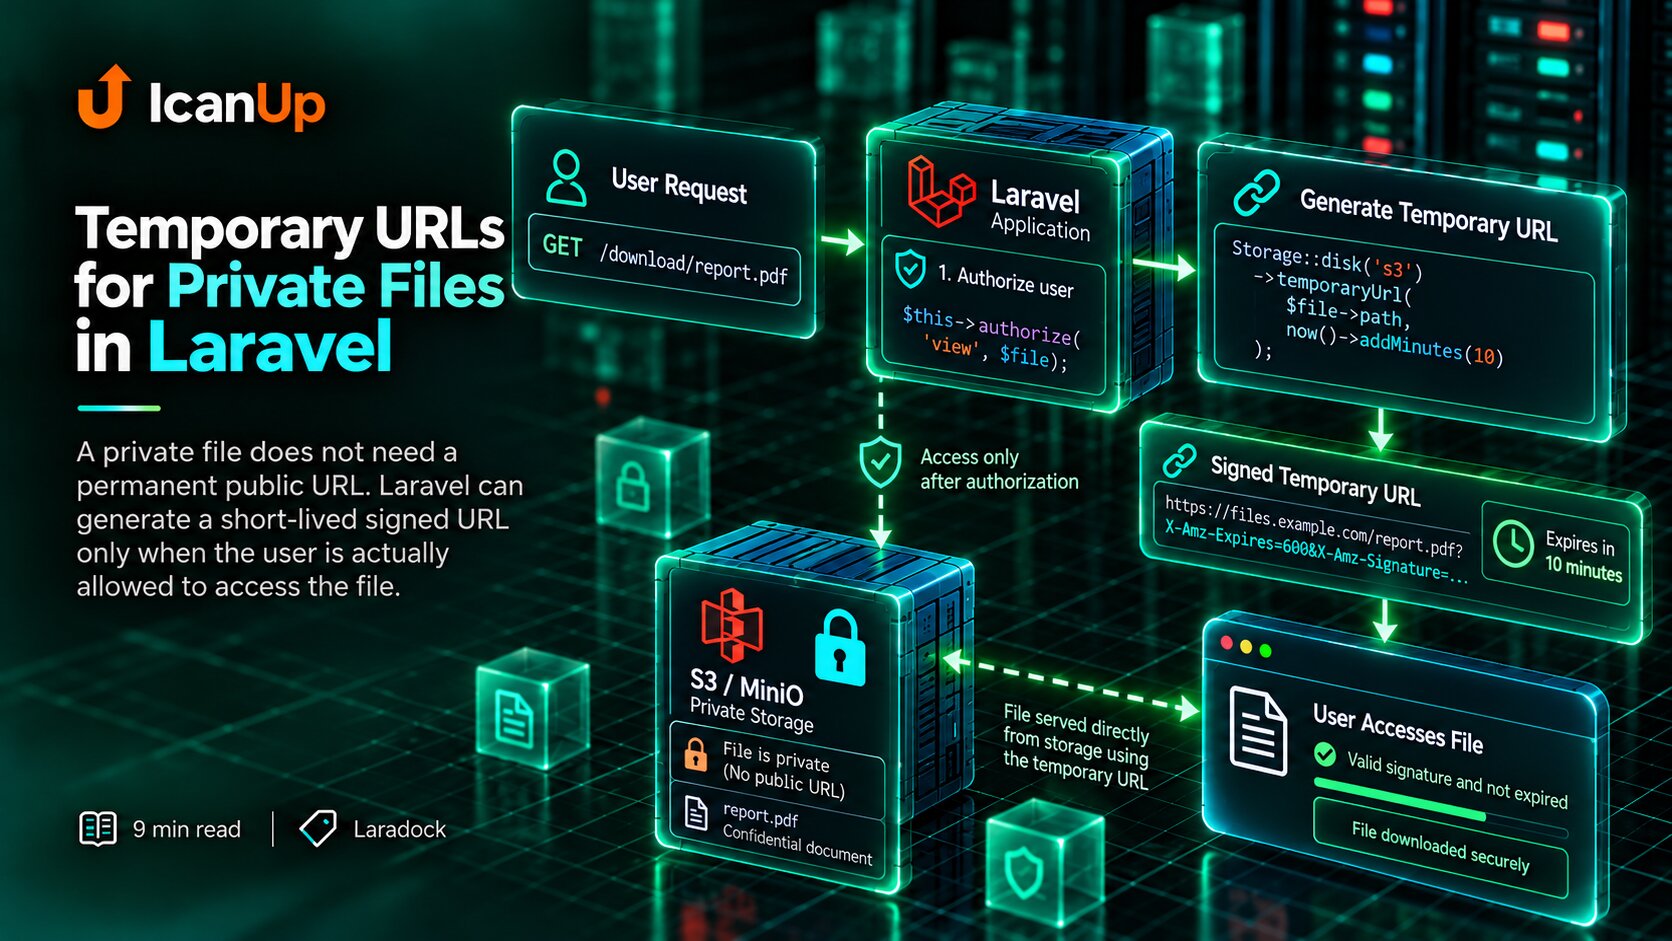
Приватному файлу не потрібна постійна публічна адреса. Laravel може створити короткоживуче підписане посилання лише тоді, коли користувачу справді дозволено отримати файл.
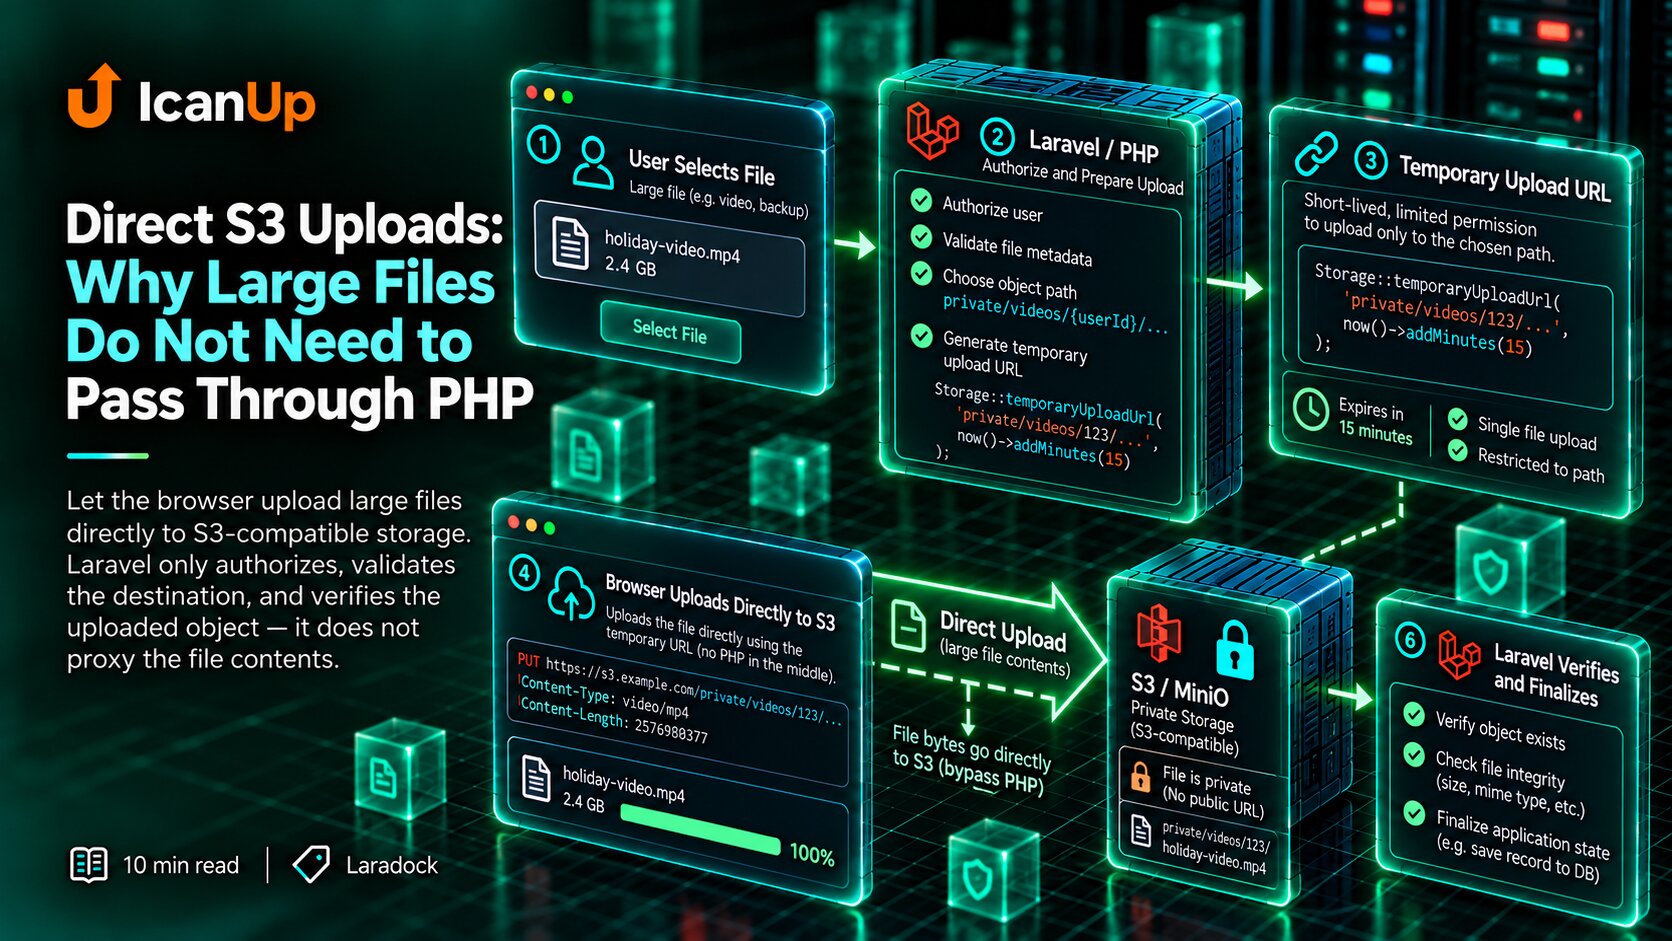
Для великого файла PHP не обов’язково має бути посередником у передаванні кожного байта. Застосунок може перевірити право, визначити шлях і видати короткоживучий дозвіл, а браузер завантажить файл безпосередньо у S3-сумісне сховище.
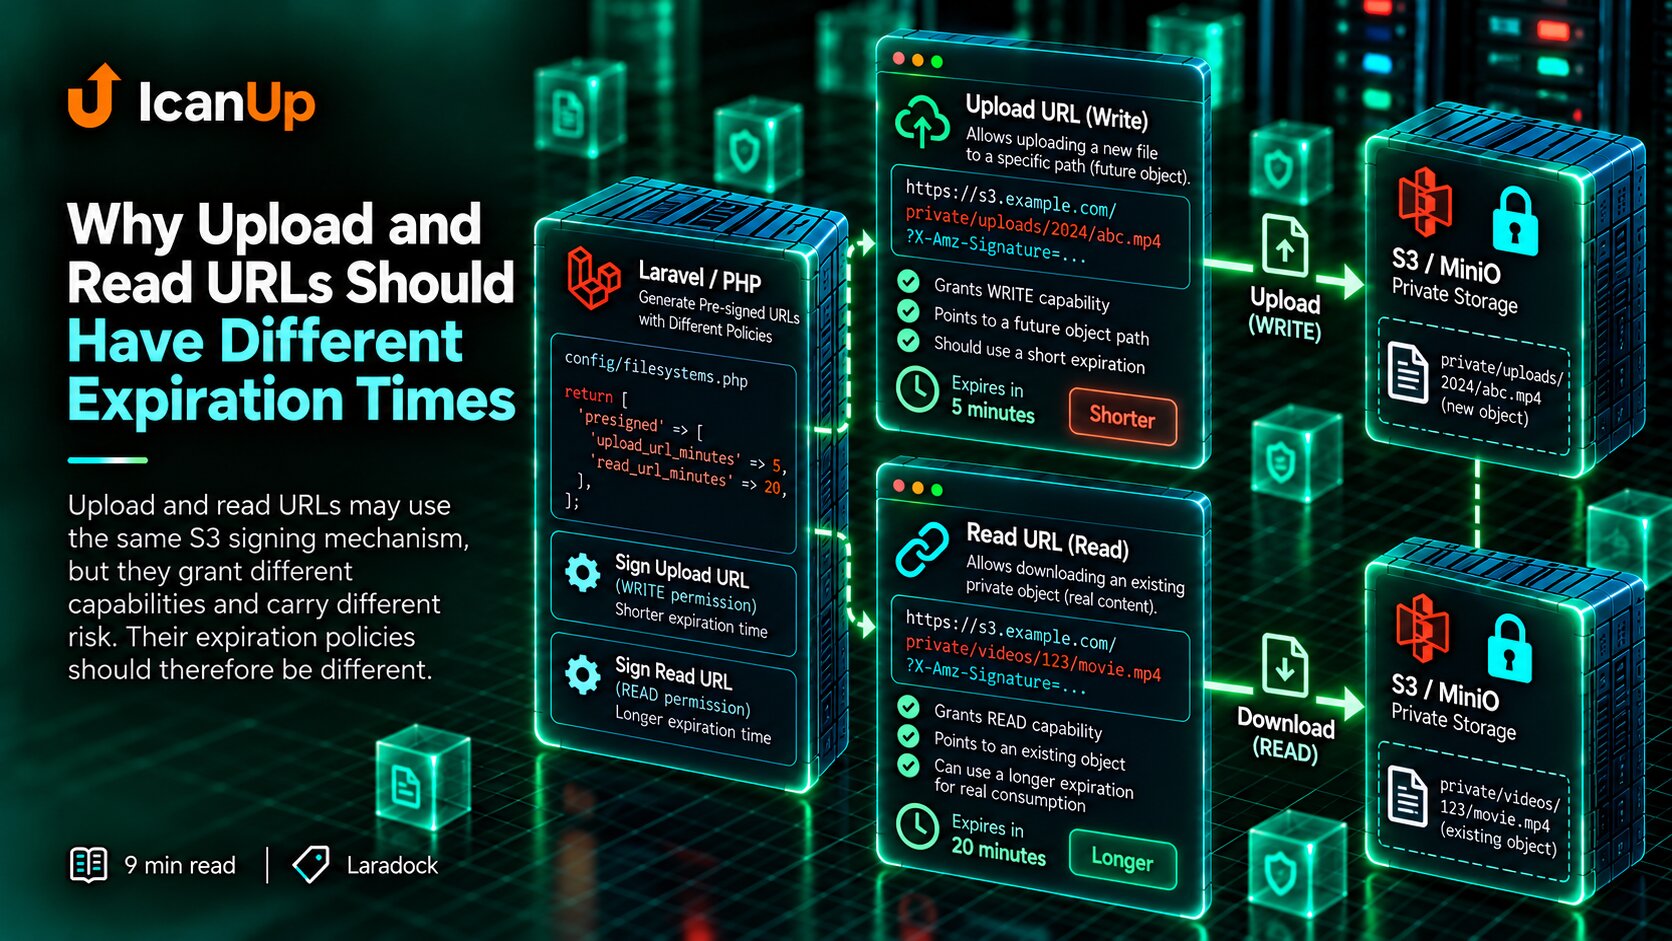
Підписані URL для запису і читання можуть використовувати той самий S3-механізм, але вони дають різні права і мають різний ризик. Тому я не використовую для них один спільний строк дії.
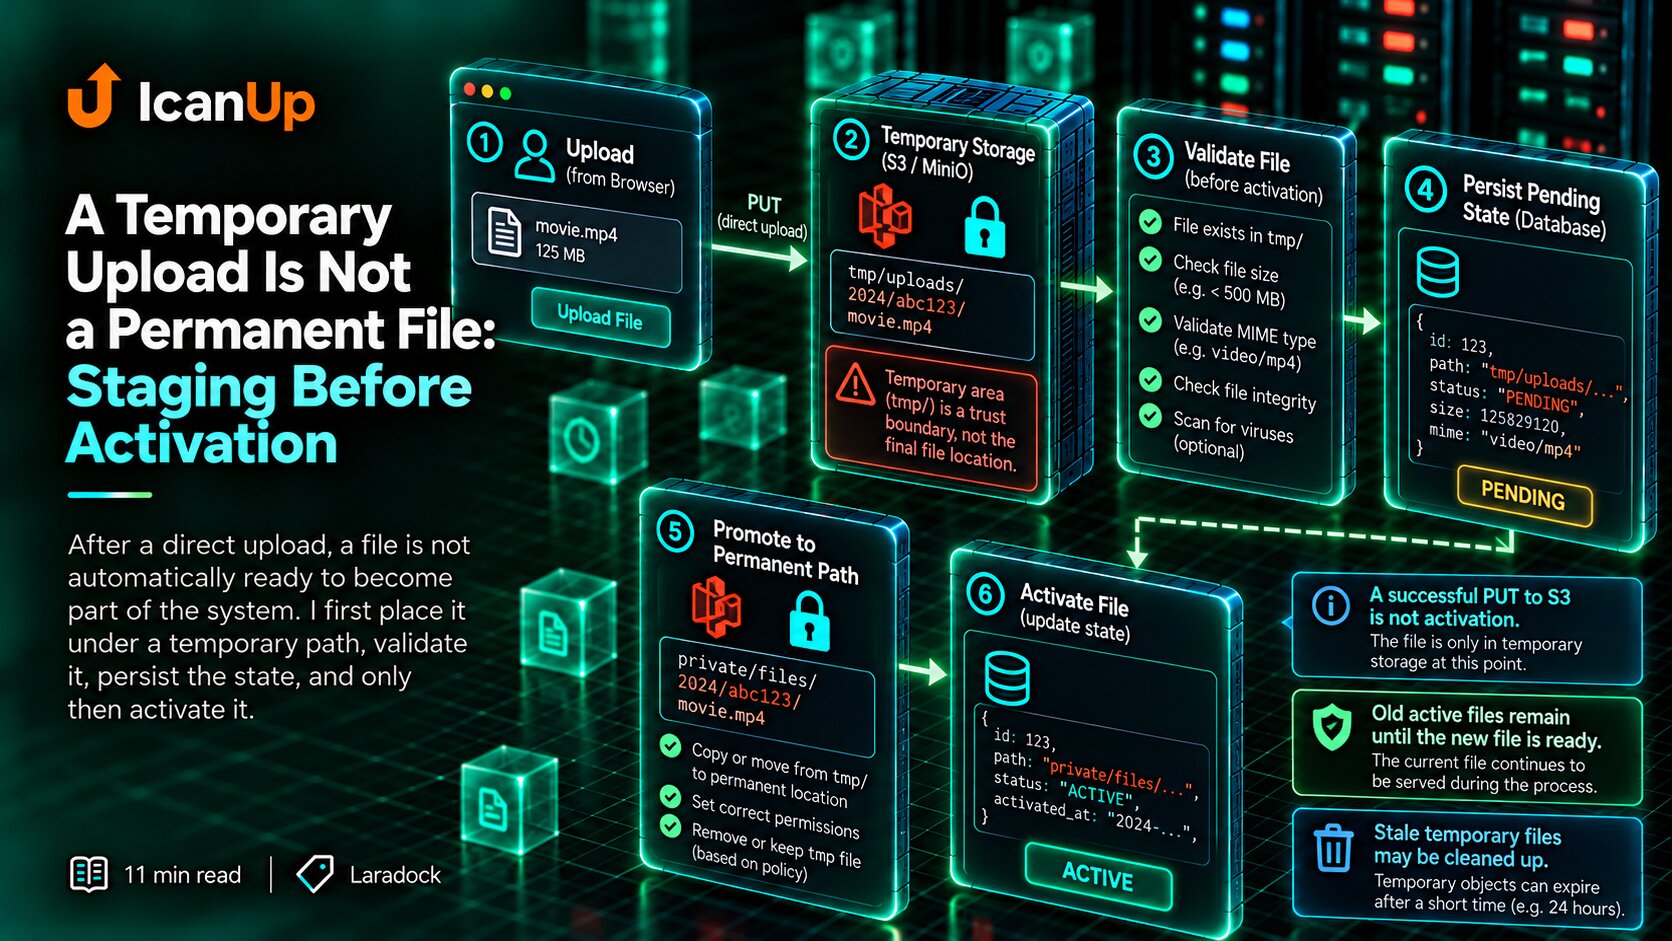
Після прямого завантаження файл ще не обов’язково готовий стати частиною системи. Я спочатку кладу його у tmp, перевіряю, зберігаю стан і лише потім активую.
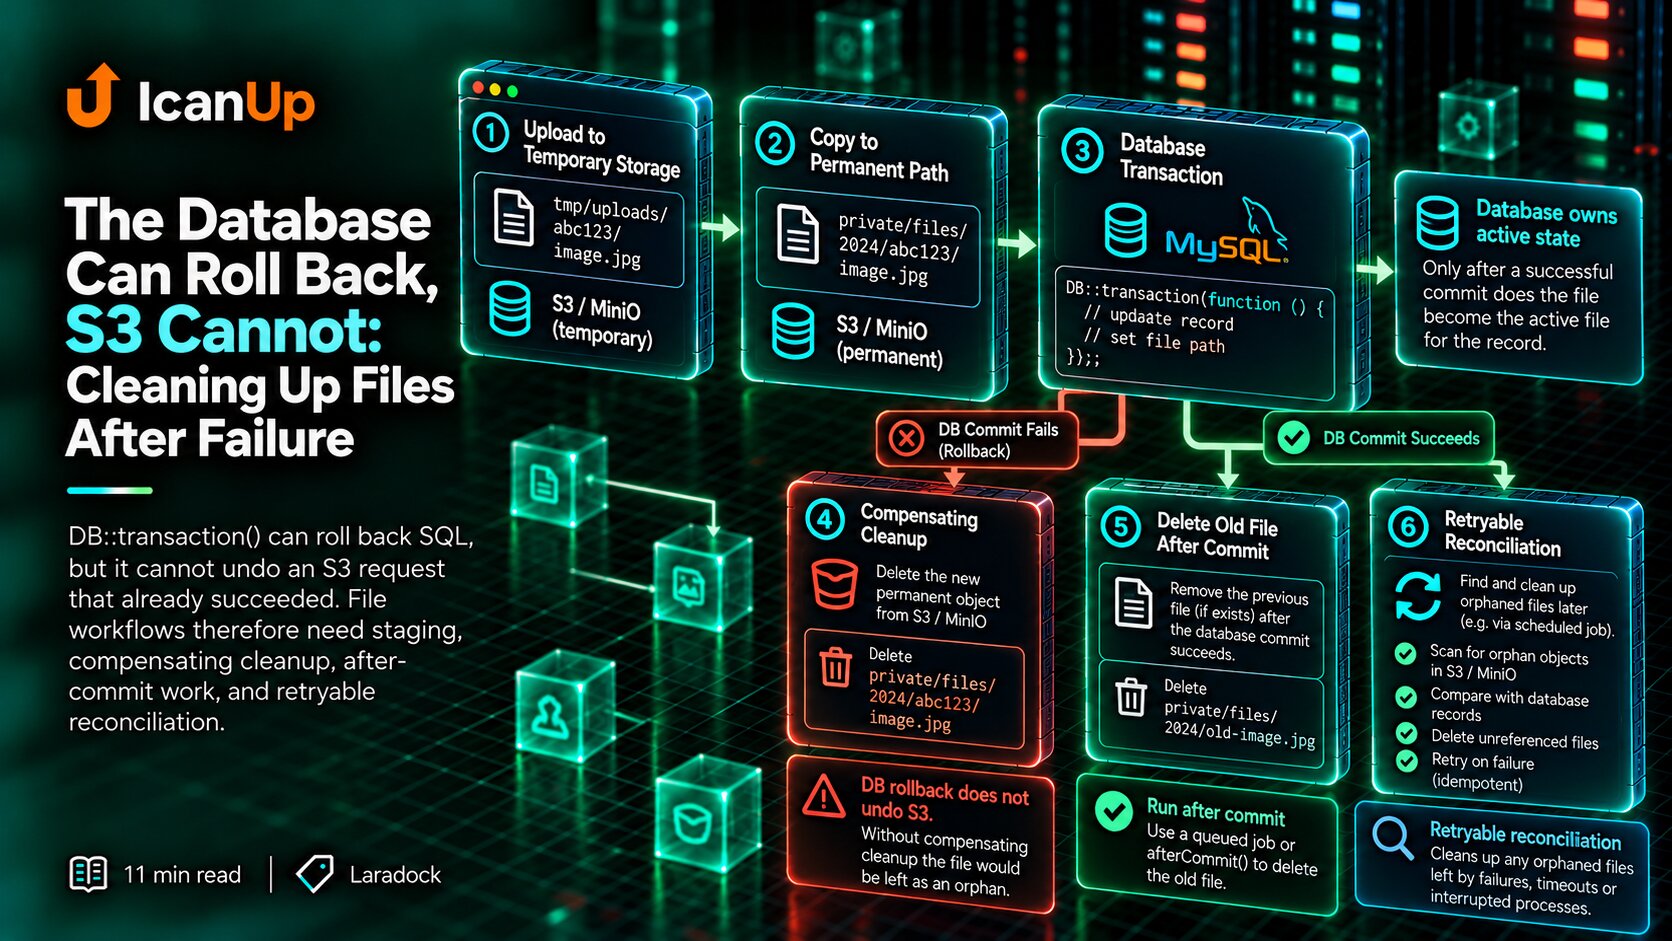
DB::transaction() може відкотити SQL, але не скасує вже виконаний S3 request. Тому роботу з файлами треба будувати через staging, компенсаційне очищення, afterCommit і повторюваний cleanup.