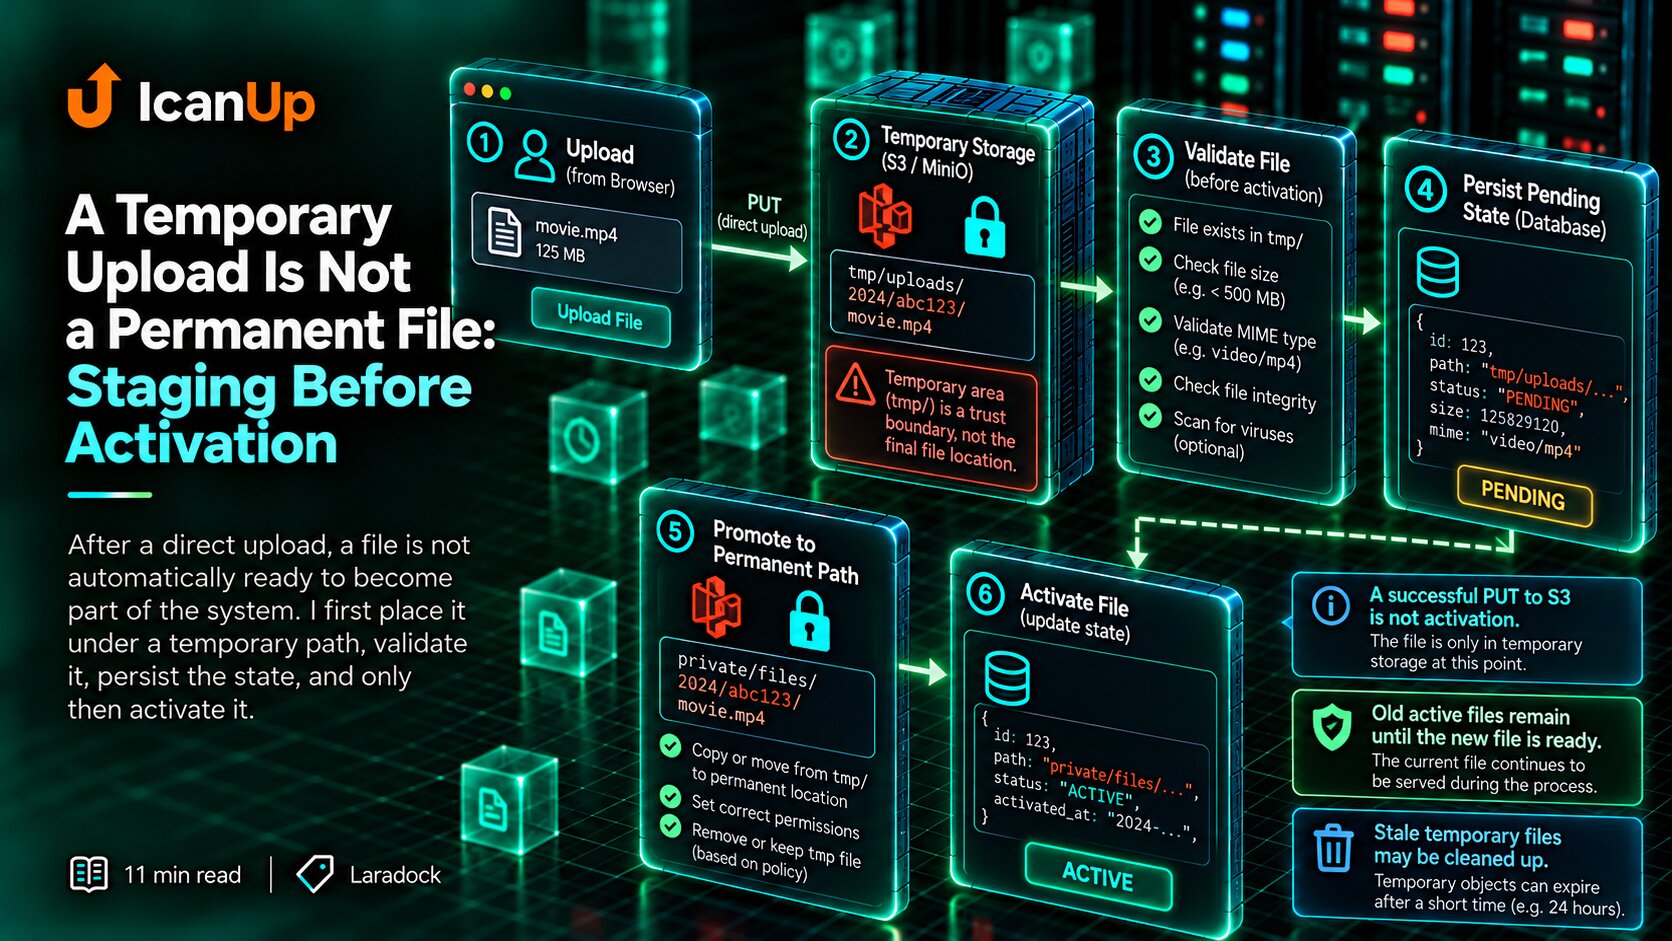
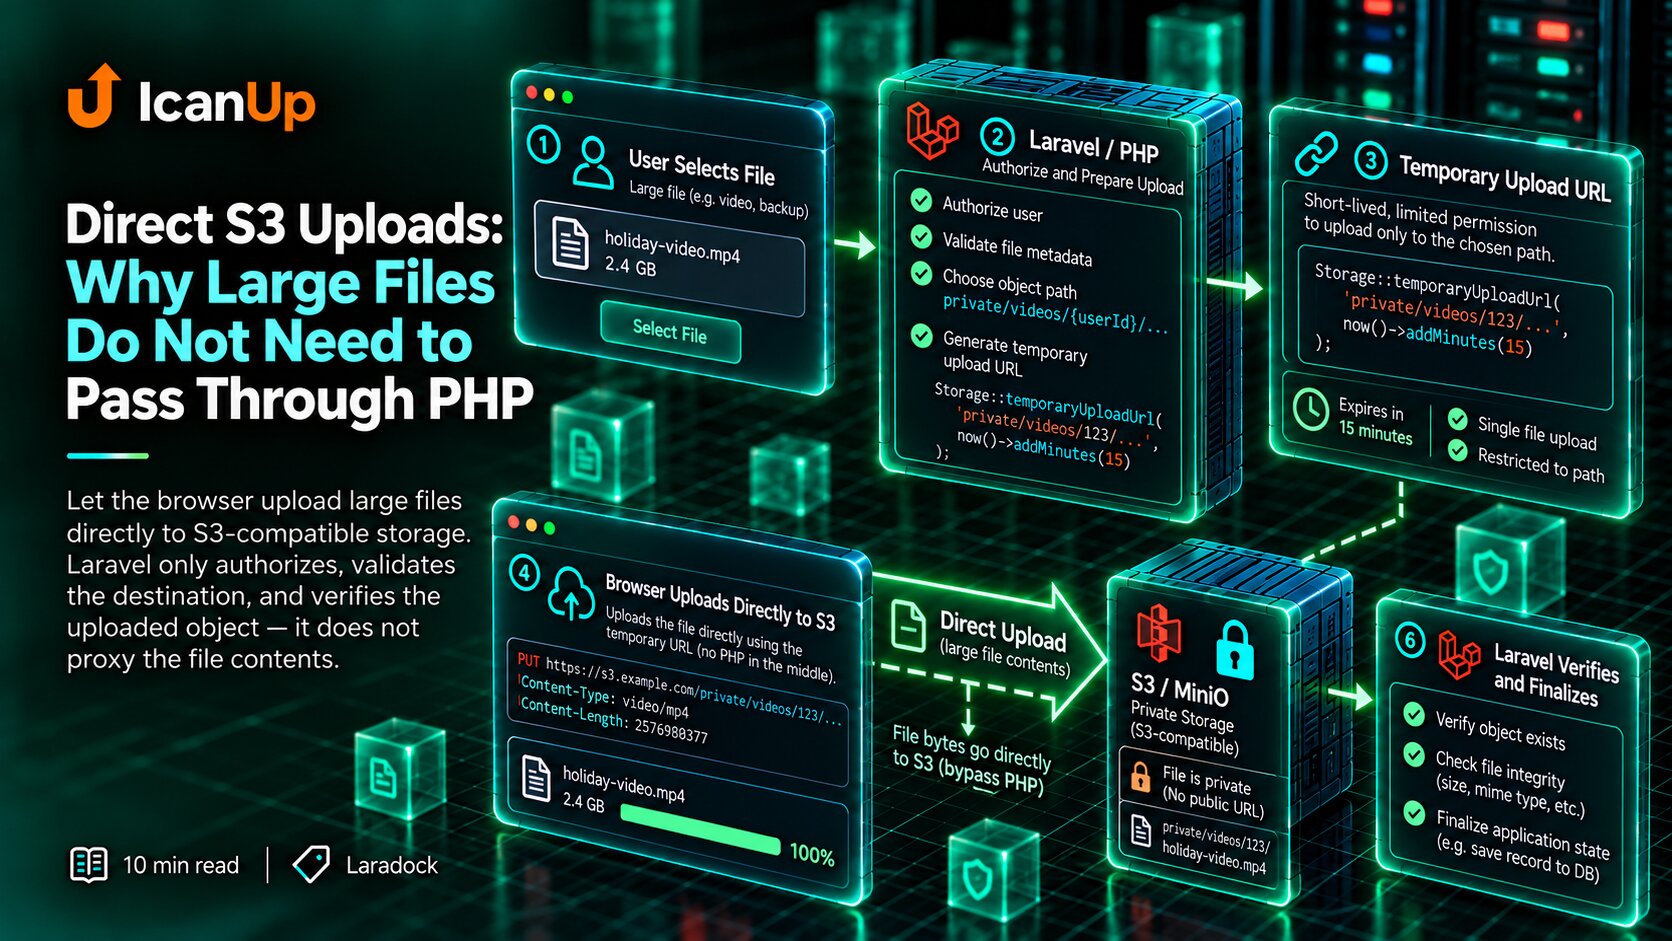
Після прямого завантаження у S3 і staging перед активацією з’являється наступне важливе питання: що робити, якщо storage operation уже завершилася, а database operation після неї впала?
У SQL ми звикли до DB::transaction(): якщо всередині виникла помилка, зміни можна відкотити.
Але S3 або MinIO не є учасником цієї транзакції. Якщо об’єкт уже скопійований, створений або видалений, database rollback цього не скасує.
Тому роботу з БД і object storage я не намагаюся уявляти як одну атомарну операцію. Замість цього я проектую порядок кроків і компенсацію для кожного failure point.
MySQL і S3 мають різні межі транзакції
MySQL | +--> BEGIN +--> UPDATE +--> INSERT +--> ROLLBACK S3 / MinIO | +--> PUT +--> COPY +--> DELETE Database rollbackДля користувача це може бути одна дія: "замінити відео".
Для системи це щонайменше дві окремі інфраструктурні операції: зміна database state і зміна object storage state.
Ці системи можуть завершитися по-різному. Саме це і треба враховувати в дизайні.
Небезпечна ілюзія: обгорнути все в DB::transaction()
DB::transaction(function () use ( $temporaryPath, $permanentPath,) { Storage::disk('s3')->copy( $temporaryPath, $permanentPath, ); File::create([ 'path' => $permanentPath, ]); throw new RuntimeException( 'Something failed later.', );Після exception запис File може зникнути через rollback.
Але $permanentPath у S3 залишиться, якщо copy уже завершився.
Це класичний orphan object: файл фізично існує, але application state більше не має на нього посилання.
Я розкладаю операцію на failure points
1. tmp upload exists2. validation passes3. permanent copy succeeds4. database update starts5. database commit succeeds6. old object cleanup runs7. tmp cleanup runs Possible failures: 3 succeeds, 4 fails-> new orphan candidate 5 succeeds, 6 fails-> old orphan candidateКоли етапи записані явно, стає простіше вирішити, що є небезпечнішим.
Для мене гірший стан - database row вказує на файл, якого немає. Менш небезпечний стан - зайвий object у storage, який ніхто не використовує.
Тому порядок кроків я будую так, щоб у разі часткової помилки система частіше отримувала orphan file, який можна прибрати, а не broken database reference, який ламає користувацький сценарій.
Для нового файла я спочатку готую storage, а потім змінюю active database state
tmp object | vvalidate | vcopy to permanent path | vverify permanent object | vdatabase transaction | vcommit active referenceЦей порядок не робить операцію атомарною.
Але він гарантує важливий інваріант: перед тим як database state почне вважати файл активним, permanent object уже має існувати.
Якщо database transaction після цього впаде, залишається зайвий storage object. Це потребує cleanup, але application state не починає посилатися на неіснуючий файл.
Якщо database commit не відбувся, новий permanent object треба компенсувати
$disk = Storage::disk('s3'); $disk->copy( $temporaryPath, $permanentPath,); if (! $disk->exists($permanentPath)) { throw new RuntimeException( 'Permanent object was not created.', );} try { DB::transaction(function () use ( $file,Тут cleanup є не rollback S3, а окремою компенсаційною дією.
Це важлива різниця: компенсація сама теж може впасти.
Тому помилку cleanup не можна мовчки ігнорувати. Її треба принаймні зафіксувати, а краще мати повторний cleanup або reconciliation process.
При заміні я не видаляю старий файл на початку
Storage::disk('s3')->delete( $oldPath,); Storage::disk('s3')->copy( $temporaryPath, $newPath,); $file->update([ 'path' => $newPath,]);Якщо copy нового файла або database update впаде після першого рядка, старий робочий ресурс уже втрачено.
Це саме той випадок, коли cleanup виконано занадто рано.
Я залишаю старий object доступним, поки новий не підготовлений і database commit не підтвердив новий active path.
Старий файл безпечніше видаляти після commit
DB::transaction(function () use ( $file, $newPath, $oldPath,) { $file->update([ 'path' => $newPath, ]); DB::afterCommit( static function () use ( $oldPath, ): void { Storage::disk('s3') ->delete($oldPath); }Тепер database state спочатку успішно переходить на новий path.
Лише після commit запускається видалення старого object.
Якщо delete старого файла впаде, користувацький сценарій все одно залишається робочим: БД уже вказує на новий існуючий файл.
afterCommit не гарантує, що cleanup точно завершиться
DB::afterCommit() вирішує проблему порядку, але не робить зовнішній request безвідмовним.
Після commit процес може завершитися, мережа може бути недоступною або S3 може тимчасово відмовити.
Тому для важливого cleanup краще мати повторювану задачу, job або reconciliation mechanism, який може завершити роботу пізніше.
Cleanup має бути безпечним для повторного виконання
if ($disk->exists($oldPath)) { $disk->delete($oldPath);}Якщо cleanup запускається повторно, його нормальний результат має бути той самий: непотрібного object більше немає.
Це особливо важливо для queued jobs, де retry є звичайною частиною роботи.
Я не хочу, щоб повторне видалення перетворювалося на окрему failure condition, якщо object уже прибраний попередньою спробою.
tmp-об’єкт теж не варто видаляти до успішної активації
tmp object | vcopy permanent object | vverify | vdatabase commit | vactive | vdelete tmpЯкщо temporary object видалити одразу після copy, а потім database commit впаде, для retry може вже не залишитися джерела.
Тому я прибираю tmp/ після успішної активації або залишаю його під cleanup policy до завершення staging window.
Cleanup failure не повинен приховати початкову помилку
try { $service->activateFile( $upload, );} catch (Throwable $original) { try { $cleanup->run( $candidatePath, ); } catch (Throwable $cleanupError) { report($cleanupError); } throw $original;}Якщо бізнес-операція впала через database exception, саме ця помилка має залишатися основною для caller-а.
Помилка компенсаційного cleanup теж важлива, але це другий failure, який треба окремо зафіксувати.
Інакше діагностика може показати лише "delete failed" і приховати те, через що взагалі почалася компенсація.
Навіть хороший synchronous cleanup потребує reconciliation
periodic reconciliation scan temporary / candidate objects | vcompare with application state | +--> referenced and valid | keep | +--> stale and unreferenced deleteНеможливо гарантувати, що процес завжди доживе до compensation code.
Процес може впасти між storage request і наступним рядком PHP.
Тому periodic reconciliation є останнім захисним шаром: він знаходить старі temporary або candidate objects, які більше не мають валідного application reference.
База визначає active state, storage зберігає bytes
Для мене важливо мати одну чітку відповідь на питання "який файл зараз активний?".
Цю відповідь дає application state у БД.
S3 може містити temporary, candidate, old і active objects одночасно. Сам факт існування object не означає, що він активний.
Саме тому orphan cleanup має звіряти storage із authoritative application state, а не навпаки.
Я відстежую cleanup як окрему частину операції
Якщо cleanup розглядається як "дрібний останній рядок", його помилки легко загубити.
Корисно окремо бачити failed compensation, failed old-file deletion, stale tmp objects і reconciliation deletions.
Тоді object storage не накопичує сміття непомітно місяцями.
Я тестую не тільки happy path, а й розриви між системами
storage copy fails- database remains unchanged- old active file remains available storage copy succeedsdatabase transaction fails- new permanent candidate is cleaned up- old active file remains authoritative database commit succeedsold-file delete fails- database points to new file- cleanup is retryable tmp delete fails- active file still worksМій список перевірки для операцій між БД і S3
Я перевіряю:
- Чи код не припускає, що
DB::transaction()може rollback-нути S3? - Чи permanent object існує до того, як БД почне вважати його active?
- Чи новий object має compensation path, якщо database commit впаде?
- Чи старий активний файл не видаляється до commit?
- Чи cleanup після commit може бути повторений?
- Чи tmp object не видаляється занадто рано?
- Чи cleanup error не приховує primary failure?
- Чи orphan objects можна знайти пізніше через reconciliation?
- Чи database state є джерелом істини для active file?
- Чи failure-path tests покривають розрив між storage і database operations?
Не шукаю магічної транзакції там, де її немає
MySQL і S3 можуть бути частинами однієї бізнес-операції, але це не робить їх однією технічною транзакцією.
Тому надійність тут з’являється не від одного DB::transaction(), а від правильної послідовності, explicit compensation, afterCommit cleanup, retries і reconciliation.
Я спочатку готую новий object, потім commit-ю authoritative database state, і лише після цього прибираю старі або temporary objects.
Database rollback захищає SQL. За зовнішні side effects відповідає окремо спроектований cleanup.
Зайвий файл у storage зазвичай безпечніше прибрати пізніше, ніж дозволити БД посилатися на файл, якого вже немає.