Режим обслуговування іноді вмикають занадто рано: спочатку сайт стає недоступним, а вже потім починаються встановлення залежностей, збірка фронтенду, перевірка конфігурації та інші кроки.
Проблема в тому, що значна частина цих операцій може завершитися помилкою ще до того, як нам взагалі потрібно торкатися активної версії застосунку.
Якщо збірка впаде через помилку JavaScript, Composer не зможе встановити залежності або конфігурація не збирається, користувачі не повинні чекати в режимі обслуговування, поки ми це з’ясуємо.
Усе, що можна перевірити до зупинки доступу, треба перевірити до зупинки доступу.
Розгортання корисно ділити на підготовку і критичне вікно
ПІДГОТОВКА- отримати код- перевірити залежності- встановити залежності- зібрати фронтенд- перевірити конфігурацію- виконати безпечні перевірки- підготувати нову версію КРИТИЧНЕ ВІКНО- увімкнути режим обслуговування, якщо він справді потрібен- виконати несумісні зміни- переключити активну версію- виконати короткі перевірки- вимкнути режим обслуговуванняЦе розділення змінює саму логіку процесу.
Поки ми перебуваємо на етапі підготовки, поточна версія сайту продовжує працювати. Якщо будь-яка перевірка падає, розгортання просто не переходить до наступної фази.
Користувачі при цьому взагалі не повинні помітити невдалу спробу.
Збірка повинна впасти до того, як сайт стане недоступним
npm cinpm run buildЗбірка фронтенду може впасти через синтаксичну помилку, відсутній пакет, несумісну версію Node.js або проблему у Vite.
Жодна з цих помилок не потребує недоступності чинного сайту.
Тому збірка має завершитися успішно ще на підготовленій новій версії, до будь-якого перемикання активного коду.
Залежності теж потрібно перевірити завчасно
composer validate --no-check-publishcomposer install \ --no-dev \ --prefer-dist \ --no-interaction \ --optimize-autoloaderПомилка в composer.lock, недоступний пакет або невідповідна версія PHP можуть зупинити встановлення залежностей.
Це ще одна категорія проблем, яку краще знайти до режиму обслуговування.
Якщо залежності не встановилися, нова версія просто не готова до активації.
Конфігурацію варто зібрати й перевірити до переключення
php artisan config:clearphp artisan config:cachephp artisan route:cachephp artisan view:cacheЯкщо config:cache або route:cache падає, це теж не причина спочатку вимикати сайт.
Такі команди можна виконати на підготовленій версії й переконатися, що застосунок здатний зібрати потрібні кеші.
Важливо лише виконувати їх у правильному каталозі нової версії, а не змінювати активну версію завчасно.
Перед критичним вікном варто перевірити й середовище
php -vnode --versioncomposer --versiondf -hНеправильна версія PHP, відсутній Node.js, недостатньо вільного місця або інша проблема середовища теж не повинні виявлятися після того, як сайт уже недоступний.
Такі перевірки дешеві й не змінюють production дані, тому їм природне місце на початку процесу.
Безпечні автоматичні перевірки теж краще виконати раніше
Якщо частину тестів, перевірку контейнера застосунку або інші безпечні перевірки можна виконати на підготовленій версії, вони теж мають бути частиною попереднього етапу.
Мета не в тому, щоб перенести абсолютно все до режиму обслуговування, а в тому, щоб залишити там лише те, що без нього не можна виконати безпечно.
Що справді може залишитися всередині режиму обслуговування
Режим обслуговування має сенс там, де є короткий проміжок несумісності між старою та новою версіями.
Наприклад, це можуть бути зміни схеми бази, які не сумісні з чинним кодом, переключення активної версії або коротка операція, під час якої одночасні записи небажані.
Навіть тут варто спочатку перевірити, чи справді потрібна повна недоступність. Частину міграцій можна проєктувати сумісними зі старою і новою версіями та виконувати без зупинки сайту.
Невдалий порядок збільшує недоступність без користі
Поганий порядок: maintenance ON -> composer install -> npm build -> config cache -> tests -> migration -> switchmaintenance OFF Якщо npm build падає:сайт уже недоступний, хоча production стан ще навіть не змінювався.Тут режим обслуговування не робить процес безпечнішим. Він лише додає користувачам час недоступності.
Якщо помилка виникла на збірці, ми ще навіть не дійшли до кроку, заради якого сайт потрібно було б тимчасово закривати.
Кращий порядок зупиняє невдале розгортання ще до недоступності
Кращий порядок: prepare release -> composer install -> npm build -> config / route / view checks -> safe tests -> environment checks if anything fails: STOP current site remains active if preflight passes: maintenance ON if required -> critical migration / switchУ цьому варіанті невдала підготовка не впливає на активний сайт.
Режим обслуговування починається тільки після того, як нова версія пройшла максимально можливу кількість перевірок.
Попередня перевірка не замінює можливість відкотитися
Навіть ідеальна підготовка не гарантує, що після переключення не виявиться проблема, яку можна побачити лише на реальному трафіку або з реальними даними.
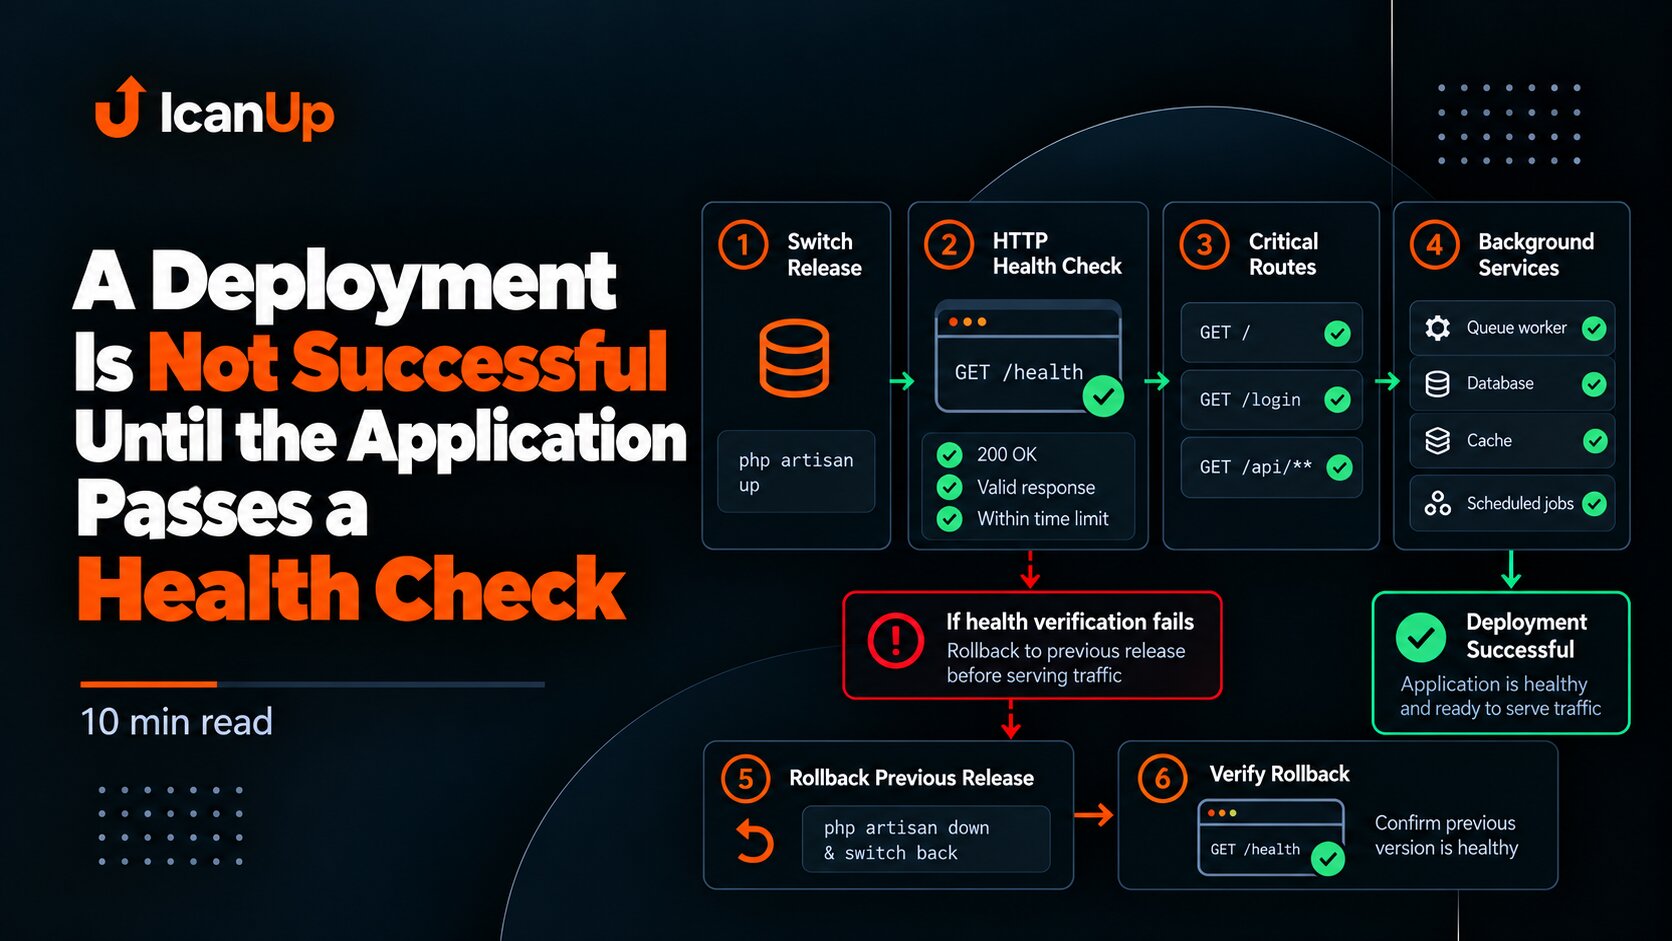
Тому потрібен окремий шлях відкату: попередня версія має залишатися доступною для повернення, а кроки після переключення - бути достатньо контрольованими.
Попередня перевірка зменшує кількість передбачуваних помилок. Відкат захищає від тих, що проявилися вже після активації.
Після переключення перевірки мають бути короткими й цільовими
Якщо сайт уже перебуває в режимі обслуговування, не варто саме в цей момент запускати довгий набір перевірок, які можна було виконати раніше.
Після переключення достатньо перевірити найважливіше: чи піднялася нова версія, чи відповідає застосунок, чи доступна база, чи працює критичний маршрут.
Довгі тести мають залишатися поза коротким вікном недоступності.
Невдала попередня перевірка повинна зупиняти процес
npm run build || exit 1php artisan config:cache || exit 1php artisan route:cache || exit 1 # Only after all preparation checks pass:php artisan downПопередня перевірка має сенс лише тоді, коли її помилка справді блокує подальше розгортання.
Якщо команда впала, а сценарій просто продовжився до php artisan down, захист існує лише формально.
Це продовження тієї самої ідеї: нестабільність треба ловити до критичної межі
Цей підхід добре поєднується з ідеєю, яку я розбирала в окремій статті про release branch як межу інтеграції: нестабільні зміни краще збирати й перевіряти до того, як вони доходять до середовища, де помилка вже впливає на користувачів.
Для розгортання такою межею є момент, коли ми починаємо змінювати активний стан або робимо сайт недоступним.
Що варто перевірити в самому процесі розгортання
1. Помилка Composer зупиняє процес до режиму обслуговування.2. Помилка npm build зупиняє процес до режиму обслуговування.3. Помилка config:cache зупиняє процес до режиму обслуговування.4. Помилка route:cache зупиняє процес до режиму обслуговування.5. Під час невдалої підготовки активний сайт продовжує працювати.6. Режим обслуговування вмикається лише перед критичними кроками.7. Після переключення виконується коротка перевірка працездатності.8. При помилці після переключення існує перевірений шлях відкату.Режим обслуговування повинен бути останньою межею, а не першим кроком
Надійне розгортання не починається з того, що ми вимикаємо сайт.
Спочатку нова версія має довести, що вона хоча б технічно готова: залежності встановлюються, збірка проходить, конфігурація збирається, середовище відповідає вимогам і безпечні перевірки успішні.
Лише після цього варто переходити до короткої частини, де справді може знадобитися режим обслуговування.
Чим пізніше в процесі починається недоступність і чим менше кроків залишається всередині неї, тим менше шансів, що користувачі чекатимуть через помилку, яку можна було знайти заздалегідь.
Не робіть сайт недоступним, щоб перевірити те, що можна було перевірити, поки він ще працює.