Сценарій розгортання може виконати всі команди без помилок і все одно залишити застосунок непрацездатним.
Код завантажився. Залежності встановилися. Міграції завершилися. Активна версія переключилася. Команда розгортання повернула код 0.
Але це ще не означає, що користувач відкриє сторінку й отримає правильну відповідь.
Розгортання завершене технічно лише тоді, коли активований застосунок пройшов перевірку працездатності.
Завершення сценарію розгортання і працездатність застосунку - різні речі
Після переключення нової версії проблема може проявитися лише під час реального запуску застосунку.
Наприклад:
- PHP-FPM не може завантажити новий код;
- застосунок падає під час запуску контейнера залежностей;
- конфігурація формально зібралася, але потрібне зовнішнє підключення недоступне;
- Nginx веде на неправильний каталог або сокет;
- черга не обробляється після перезапуску процесів;
- WebSocket-сервер або інший критичний процес не піднявся.
Жодна з цих проблем не обов’язково зламає саму команду переключення версії.
Найпростіша перевірка - реальний HTTP-запит після переключення
curl \ --fail \ --silent \ --show-error \ https://example.com/healthВажливо, що цей запит має йти саме через той шлях, яким користується реальний клієнт: через вебсервер, PHP-FPM і активний застосунок.
Перевірка лише локального файлу або існування каталогу не доводить, що весь ланцюг відповіді працює.
curl --fail додатково робить невдалий HTTP-статус помилкою команди, щоб сценарій розгортання міг зупинитися.
Перевірка працездатності повинна доводити достатньо, але не робити все
Сторінка перевірки не повинна запускати великий набір тестів або виконувати важкі бізнес-операції.
Її задача - швидко відповісти, чи здатний активний застосунок обробити базовий запит і чи доступні критичні залежності, без яких він не може працювати.
Наприклад, перевірка може підтверджувати, що Laravel завантажився і база даних доступна. Але вона не повинна створювати замовлення, надсилати листи або змінювати production дані.
Одного службового endpoint іноді недостатньо
Службова перевірка може бути зеленою, але помилка все ще залишатися в маршруті, який використовують користувачі.
Тому після базової перевірки корисно виконати один або кілька коротких запитів до критичних публічних маршрутів: головної сторінки, основного API або іншої безпечної точки, яка не змінює дані.
curl \ --fail \ --silent \ --show-error \ --output /dev/null \ https://example.com/ curl \ --fail \ --silent \ --show-error \ --output /dev/null \ https://example.com/api/statusHTTP-відповідь не перевіряє фонові процеси
Laravel-застосунок може правильно відповідати через HTTP, але частина системи все одно залишатися непрацездатною.
Якщо продукт залежить від черг, планувальника, WebSocket-сервера або окремого процесу серверного рендерингу, їхній стан теж входить у поняття успішного розгортання.
Тому сценарій повинен знати, які процеси є критичними саме для цього застосунку.
supervisorctl statussystemctl is-active php8.5-fpmsystemctl is-active nginxСтатус процесу ще не доводить, що він виконує роботу
Навіть статус RUNNING або active не завжди достатній.
Процес може бути запущений, але не мати доступу до Redis, бази даних або потрібної черги.
Для критичних фоновых механізмів варто мати окремий спосіб підтвердити не лише існування процесу, а і його здатність виконувати потрібну роботу.
Це може бути безпечний службовий показник, контроль затримки черги або інша перевірка, яка не створює побічних ефектів.
Після перезапуску потрібне коротке контрольоване очікування
for attempt in 1 2 3 4 5; do if curl \ --fail \ --silent \ --show-error \ --output /dev/null \ https://example.com/health then exit 0 fi sleep 2done exit 1Новому процесу іноді потрібна секунда або кілька секунд, щоб почати відповідати.
Тому одна миттєва перевірка може дати хибну помилку. Але й нескінченно чекати не можна.
Краще мати коротку обмежену кількість повторів, після якої стан однозначно вважається невдалим.
SUCCESS має стояти після перевірки, а не після копіювання файлів
prepare -> deploy -> migrate -> switch release -> restart required processes -> HTTP health check -> critical route checks -> runtime checks only then: SUCCESSЦе важлива семантична межа для CI/CD.
Якщо система повідомляє про успіх одразу після git checkout, копіювання файлів або переключення символьного посилання, вона підтверджує лише виконання операції з файлами.
Для користувача успішне розгортання означає інше: нова версія доступна й виконує потрібну роботу.
Невдала перевірка після переключення повинна запускати відкат
Якщо нова версія вже стала активною, але перевірка працездатності не пройшла, просто позначити pipeline червоним недостатньо.
Користувачі в цей момент уже можуть отримувати помилки.
Якщо розгортання підтримує безпечний автоматичний відкат, саме тут він має сенс: повернути попередню версію, відновити потрібні процеси й тільки після цього завершити невдалий запуск.
new release active -> health FAILED -> rollback previous release -> restart required processes -> verify previous release -> deployment FAILED, service restoredВідкат теж потрібно перевірити
Команда відкату може виконатися успішно, але це ще не доводить, що сервіс відновився.
Після повернення попередньої версії потрібно повторити ті самі короткі перевірки: HTTP-відповідь, критичний маршрут і потрібні процеси.
Інакше ми лише замінимо неперевірене розгортання неперевіреним відкатом.
Відкат коду не завжди означає безпечний відкат бази
Автоматичний відкат особливо простий, коли зміни бази сумісні з попередньою версією застосунку.
Якщо міграція видалила колонку або незворотно змінила дані, повернення старого коду може вже не відновити працездатність.
Тому здатність відкотити реліз починається ще на етапі проєктування змін схеми: по можливості нова і попередня версії мають короткий час залишатися сумісними.
Попередня перевірка і перевірка після розгортання закривають різні ризики
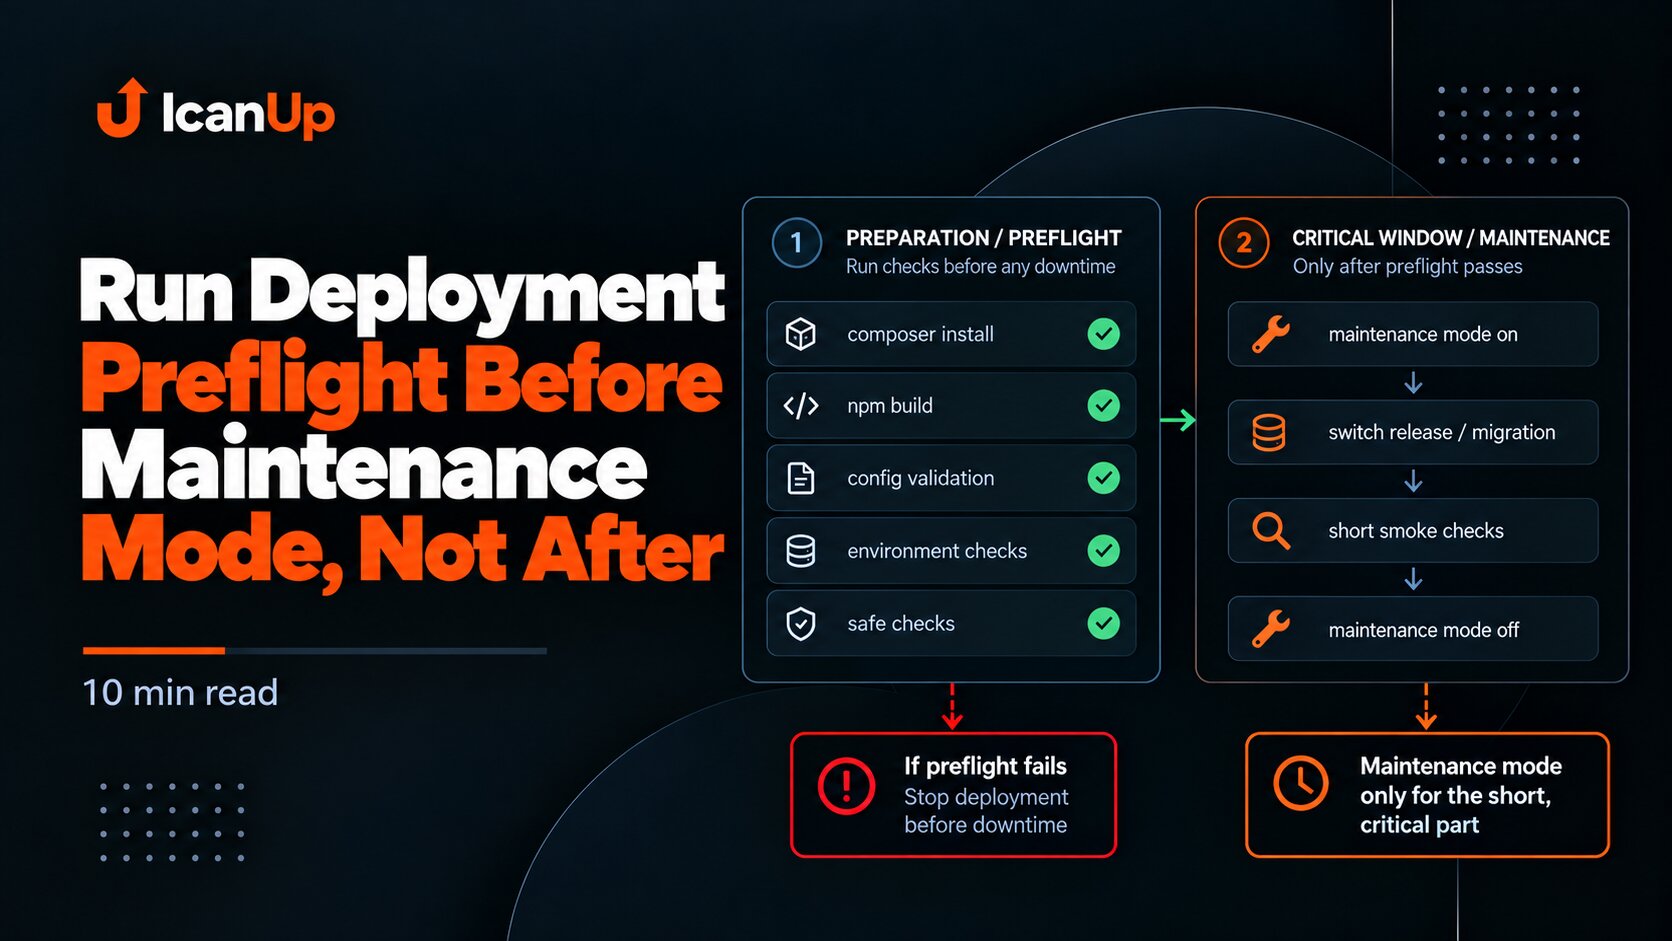
У окремій статті про перевірки до режиму обслуговування я розбирала іншу межу: збірку, залежності й конфігурацію треба перевірити ще до того, як сайт стане недоступним.
Але навіть ідеальна попередня перевірка не бачить усього, що станеться після активації нової версії.
Тому процес має дві окремі гарантії:
- до переключення - нова версія достатньо підготовлена, щоб її активувати;
- після переключення - активована версія реально працює.
Це також продовжує принцип із матеріалі про release branch як межу інтеграції: кожна межа процесу має власний критерій готовності.
Перевірений код у гілці ще не означає успішного розгортання, так само як успішне копіювання файлів ще не означає працездатного застосунку.
Що варто перевірити в CI/CD
1. Pipeline не повідомляє SUCCESS одразу після переключення версії.2. Невдалий HTTP health check завершує deploy як failed.3. Критичний публічний маршрут перевіряється після переключення.4. Перевіряються потрібні runtime-процеси.5. Короткий retry має обмежену кількість спроб.6. Невдалий health check запускає rollback, якщо він безпечний.7. Після rollback повторно перевіряється HTTP і runtime.8. SUCCESS з'являється тільки після всіх обов'язкових перевірок.Успіх розгортання визначає працездатний сервіс, а не остання виконана команда
CI/CD не повинен плутати успішне виконання сценарію з успішним станом системи.
Після переключення нової версії потрібно хоча б підтвердити HTTP-відповідь і стан критичних процесів. Якщо ці перевірки не пройшли, розгортання ще не успішне.
А якщо після помилки виконується відкат, його результат теж має бути перевірений.
Правильна межа SUCCESS проходить не після останньої команди deploy, а після доказу, що активний застосунок справді працює.
Розгортання завершене не тоді, коли файли на місці, а тоді, коли нова активна версія пройшла перевірку працездатності.