Коли в ICanUp з'явилися Reverb, фонові задачі та Inertia SSR, одного PHP-FPM уже було недостатньо для всього production-застосунку.
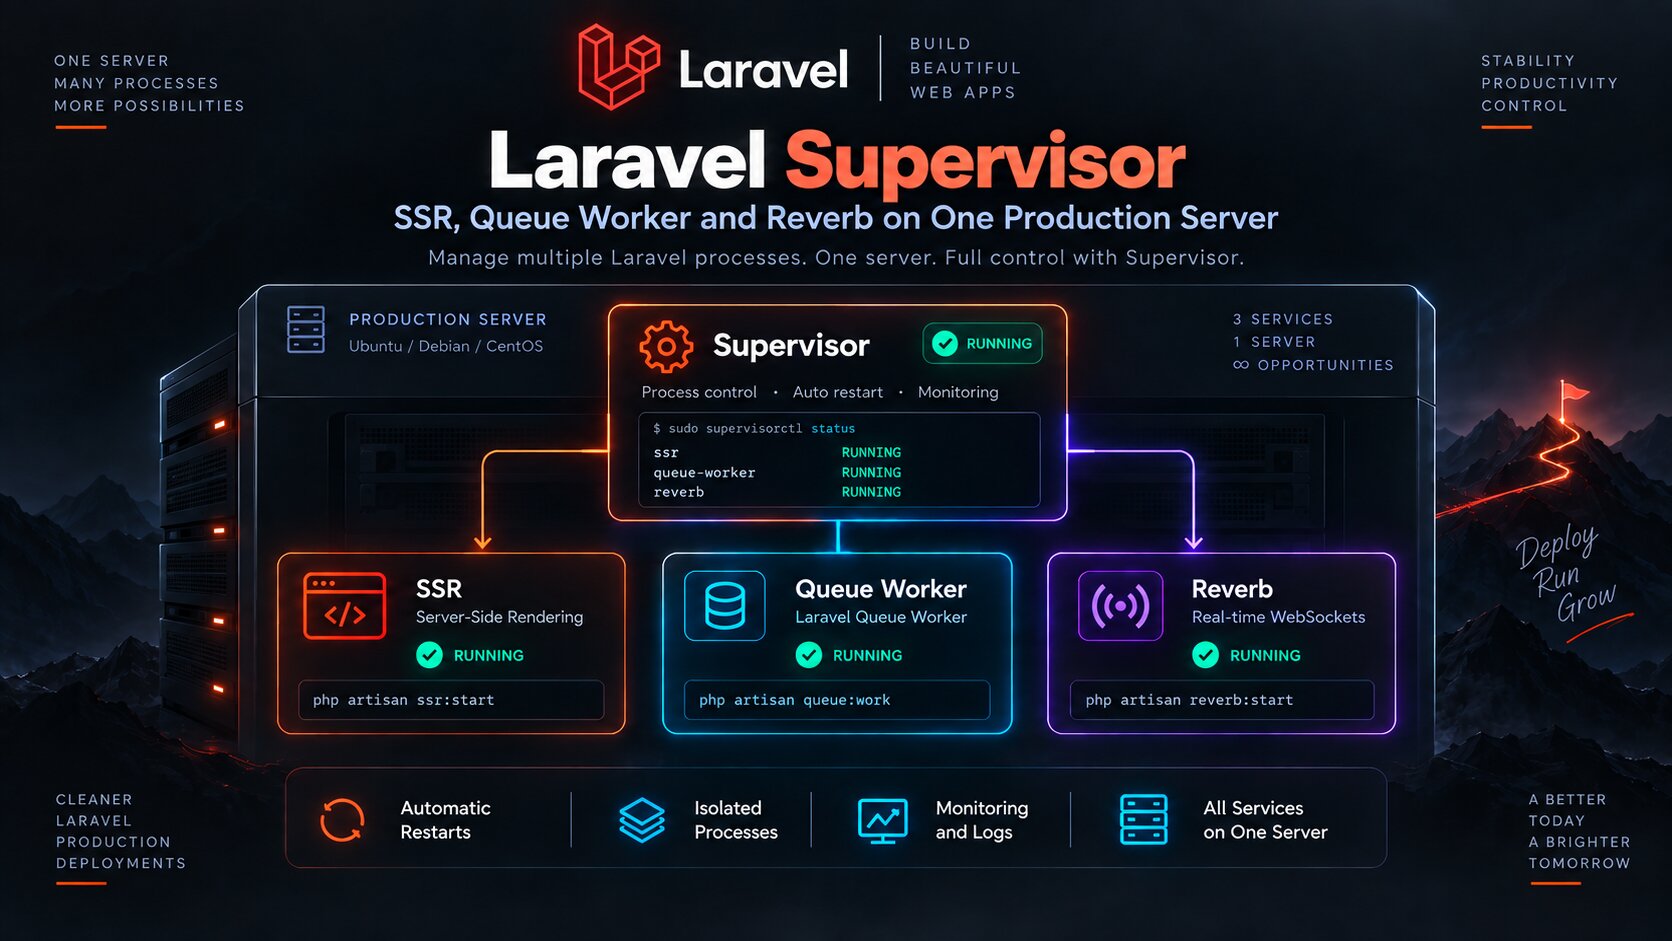
На сервері одночасно повинні постійно працювати три окремі процеси: обробник черги, Reverb і SSR.
Кожен із них може зупинитися незалежно від інших. І що важливіше, несправність одного процесу не завжди робить весь сайт очевидно недоступним.
Саме тому я використовую Supervisor не як зручну команду запуску, а як єдиний контракт керування довготривалими процесами застосунку.
Один Laravel-застосунок не означає один процес
HTTP-запити в моєму production-середовищі обробляє PHP-FPM. Але частина функціональності живе поза звичайним HTTP request-response циклом.
Черга повинна обробляти фонові задачі. Reverb повинен постійно приймати WebSocket-з'єднання. SSR повинен бути готовим серверно рендерити Inertia-сторінки.
Це різні процеси з різними командами, помилками та способом перевірки.
Процес | За що відповідає | Що помітить користувач при збої |
|---|---|---|
Laravel queue worker | Фонові задачі | Сайт може відкриватися, але задачі накопичуються або виконуються із затримкою |
Reverb | WebSocket та realtime-події | HTTP працює, але живі оновлення перестають приходити |
Inertia SSR | Серверний рендеринг Vue/Inertia | Звичайна сторінка може ще відкриватися, але SSR або SEO-відповідь працює неправильно |
Саме це робить проблему неочевидною
Якщо падає PHP-FPM, проблема очевидна: HTTP-запити перестають нормально оброблятися.
З довготривалими процесами все складніше.
Зупинений обробник черги може кілька хвилин або годин залишатися непомітним. Reverb може не працювати, хоча звичайна навігація сайтом справна. SSR може падати лише на конкретній сторінці або конкретному сценарії.
Тому "сайт повертає 200" і "всі процеси застосунку справні" - це різні твердження.
У production я маю три окремі Supervisor programs
У поточному production-середовищі ICanUp Supervisor керує окремими процесами для worker, Reverb та SSR.
Їхні імена навмисно різні, щоб кожен сервіс можна було перевірити або перезапустити незалежно.
icanup-worker:icanup-worker_00icanup-reverbicanup-ssrЦе важлива деталь. Я не хочу перезапускати весь application stack лише тому, що потрібно оновити один процес.
Перша команда після deployment - перевірити фактичний стан
sudo supervisorctl statusЯ очікую побачити потрібні процеси у стані RUNNING.
Але це лише перший рівень перевірки.
icanup-worker:icanup-worker_00 RUNNINGicanup-reverb RUNNINGicanup-ssr RUNNINGRUNNING означає лише те, що процес не завершився
Supervisor добре відповідає на питання: "Чи живий процес?"
Але він не завжди може відповісти на питання: "Чи виконує цей процес свою роботу правильно?"
Supervisor показує | Але окремо потрібно перевірити |
|---|---|
worker = RUNNING | Чи справді обробляються задачі черги |
Reverb = RUNNING | Чи слухається потрібний порт і працюють WebSocket-з'єднання |
SSR = RUNNING | Чи реальна сторінка успішно проходить серверний рендеринг |
Обробник черги є довготривалим PHP-процесом
Laravel queue worker не завершується після одного завдання. Він залишається в пам'яті та чекає наступної роботи.
Це означає, що після нового deployment він може продовжувати працювати зі старим завантаженим кодом, доки не буде коректно перезапущений.
php artisan queue:restartqueue:restart дає workers сигнал завершитися після поточної роботи. Після цього Supervisor запускає процес знову.
У deployment я також можу явно перевірити або перезапустити Supervisor group.
sudo supervisorctl restart icanup-worker:*Reverb живе окремо від HTTP-запитів
Reverb підтримує довготривалі WebSocket-з'єднання.
Його збій не обов'язково вплине на звичайний HTTP request. Користувач може відкрити сторінку, але realtime-функції вже не працюватимуть.
Саме тому Reverb має власний Supervisor program.
sudo supervisorctl restart icanup-reverbПісля перезапуску я перевіряю не тільки Supervisor status, а й те, що сервер слухає очікувані порти.
ss -lntSSR теж повинен бути постійно запущеним
Після підключення Inertia SSR у мене з'явився ще один довготривалий процес.
Його задача - приймати запити від Laravel та повертати серверно відрендерений HTML для Inertia-сторінок.
Якщо процес SSR зупиниться або почне падати, це може проявитися не так очевидно, як повний HTTP outage.
sudo supervisorctl restart icanup-ssrОкремо я перевіряю реальний HTML сторінки. Саме так свого часу в ICanUp було видно різницю між метатегами, які зʼявлялися лише в браузері, та метатегами у початковій SSR-відповіді.
Цей випадок я окремо описала у матеріалі про Inertia SSR і метатеги в початковому HTML.
curl -s https://icanup.com.ua/ \ | grep -E '<title>|og:title'Кожен процес має запускатися окремо
Я не обʼєдную worker, Reverb та SSR в один shell script, який Supervisor бачить як один process.
Якщо такий спільний процес частково зламається, стає складніше зрозуміти, що саме впало, перезапустити лише потрібний сервіс і мати окремі журнали.
Supervisor|+-- icanup-worker|+-- icanup-reverb|+-- icanup-ssrКонфігурація має описувати життєвий цикл, а не тільки команду
Для мене Supervisor configuration - це не просто command=....
Важливо також явно визначити робочу директорію, користувача, автоматичний запуск, поведінку після збою та коректну зупинку процесу.
[program:example-process]directory=/var/www/icanupcommand=<process-command>user=deploy autostart=trueautorestart=true startsecs=5stopsignal=TERMstopasgroup=truekillasgroup=true redirect_stderr=truestdout_logfile=<process-log>Чому я використовую autorestart
Довготривалий процес може завершитися не тільки під час deployment.
Помилка runtime, нестача ресурсу або непередбачений exception можуть зупинити його вже після успішного запуску.
autorestart=true дозволяє Supervisor повторно запустити процес без ручного втручання.
Але нескінченний restart loop не є виправленням причини. Якщо process постійно падає, потрібні його журнали і окрема діагностика.
Правильний користувач процесу важливий не менше за команду
У моєму production-середовищі довготривалі CLI/SSR процеси можуть працювати від користувача deploy, тоді як HTTP через PHP-FPM обробляє www-data.
Це окремий системний контракт прав доступу.
Я не запускаю application processes від root лише для того, щоб обійти permission problem.
Якщо кілька системних користувачів записують спільні файли, права доступу потрібно проєктувати явно. Supervisor не виправляє неправильні permissions автоматично.
Після зміни Supervisor config недостатньо просто restart
Коли змінюється саме Supervisor configuration, спочатку потрібно попросити Supervisor перечитати її.
sudo supervisorctl rereadsudo supervisorctl updatesudo supervisorctl statusreread знаходить зміни у configuration files, а update застосовує новий набір programs.
Це відрізняється від звичайного restart уже відомого process.
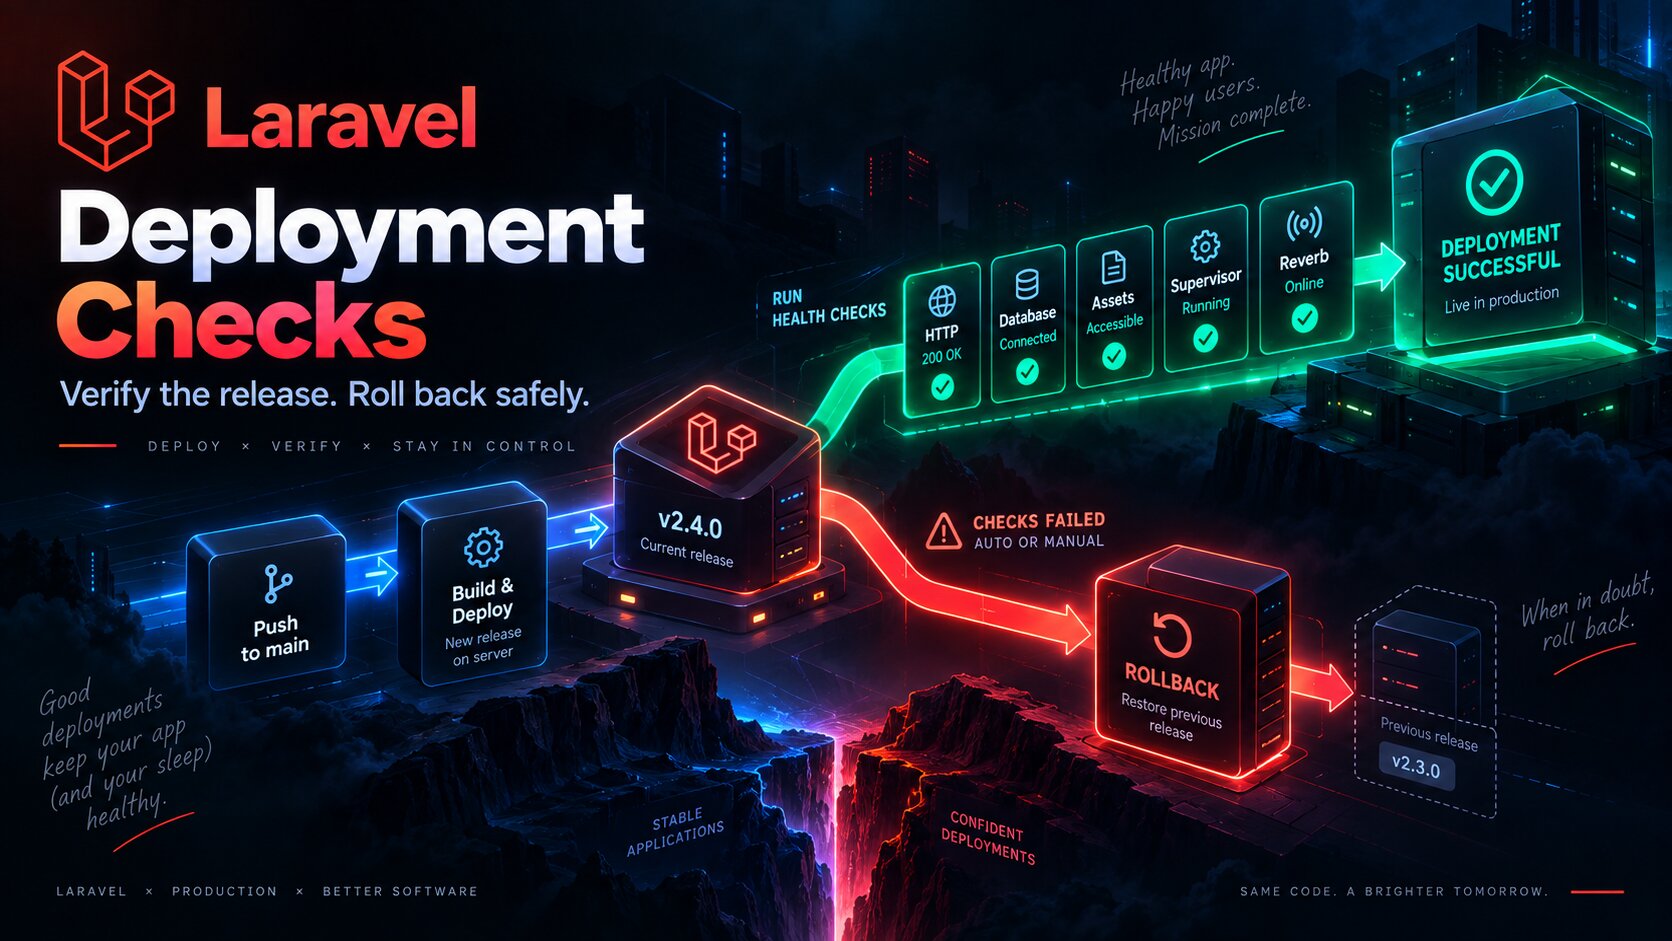
Після deployment довготривалі процеси мають отримати новий код
Одна з найважливіших практичних причин керувати цими процесами через Supervisor - deployment.
Після оновлення Git revision, Composer dependencies, frontend build або environment configuration старий process може залишатися в памʼяті зі старим станом.
Тому deployment не завершується на оновленні файлів.
Deploy new code | vRebuild dependencies / caches | vRestart long-running processes | +-- Queue worker +-- Reverb +-- SSR | vVerify process state | vVerify real service behaviorМій порядок після deployment
- Оновити application code та dependencies.
- Виконати migrations і перебудувати Laravel caches.
- Попросити Laravel queue workers завершитися коректно.
- Перезапустити worker group під Supervisor.
- Перезапустити Reverb.
- Перезапустити SSR.
- Перевірити
supervisorctl status. - Перевірити listening ports для потрібних мережевих процесів.
- Перевірити реальний HTTP та SSR output.
- Лише після цього вважати deployment успішним.
Це продовження CI/CD, а не окрема ручна процедура
Я не хочу памʼятати ці кроки щоразу вручну.
У ICanUp перезапуск і перевірка довготривалих процесів є частиною deployment flow.
Більший контекст цього процесу я описувала у матеріалі про реальний Laravel CI/CD pipeline.
Не всі три процеси потрібно масштабувати однаково
Queue worker природно може мати кілька processes, якщо кількість задач зростає.
Для цього Supervisor підтримує групи та кілька екземплярів одного program.
Reverb і SSR на одному сервері мають іншу модель. Без окремої архітектурної причини я не запускаю випадкові дублікати процесів, які конкурують за той самий port або endpoint.
Окремі журнали значно спрощують діагностику
Якщо worker, Reverb та SSR пишуть усе в один загальний process log, під час збою доводиться спочатку визначати, до якого сервісу належить повідомлення.
Окремі журнали дають простіший звʼязок:
worker failure -> worker logReverb failure -> Reverb logSSR failure -> SSR logПри цьому application logging Laravel залишається окремим рівнем. Supervisor logs і Laravel logs відповідають на різні питання.
Що я перевіряю, якщо process постійно перезапускається
- Команду Supervisor і робочу директорію.
- Користувача, від якого запускається process.
- Environment variables, доступні цьому process.
- Права доступу до потрібних файлів і каталогів.
- Окремий process log.
- Laravel log, якщо process завантажує Laravel.
- Чи не зайнятий потрібний port іншим process.
- Чи працює та сама команда вручну від того самого системного користувача.
Перевірка команди вручну має повторювати Supervisor context
Якщо команда працює в моєму SSH shell, це ще не гарантує, що вона працює під Supervisor.
Можуть відрізнятися user, working directory, environment та PATH.
Тому при діагностиці я намагаюся повторити саме той context, у якому Supervisor запускає process.
Команда, яка працює вручну, і процес, який Supervisor може стабільно підтримувати в production, - не завжди одне й те саме.
Supervisor не замінює перевірки працездатності
Я спеціально розділяю process supervision і health verification.
Supervisor повинен тримати процес запущеним. Deployment verification повинна довести, що цей процес виконує свою функцію.
Рівень | Приклад перевірки |
|---|---|
Process |
|
Network | Чи слухається потрібний port |
Application | Чи виконується реальна задача або SSR render |
Public behavior | Чи працює очікувана функція для користувача |
Найгірший сценарій - тихий частковий збій
Для мене найнебезпечніший випадок - не повний outage, а ситуація, коли сайт виглядає працездатним лише частково.
HTTP відповідає, але queue worker стоїть. Сторінка відкривається, але realtime не працює. Браузер бачить контент, але SSR падає і початковий HTML неправильний.
Саме тому три довготривалі процеси повинні мати окреме керування і окремі перевірки.
Що я не роблю
- Не запускаю worker, Reverb та SSR одним спільним shell process.
- Не запускаю application processes від
rootзаради зручності. - Не вважаю
RUNNINGдостатнім доказом працездатності сервісу. - Не запускаю другий Reverb вручну, не перевіривши Supervisor.
- Не залишаю довготривалі processes зі старим кодом після deployment.
- Не змішую журнали всіх process roles в один потік без потреби.
- Не перезапускаю весь server лише через збій одного application process.
- Не перевіряю production тільки одним HTTP 200.
Мій короткий Supervisor checklist
- Кожна довготривала роль має окремий Supervisor program.
- Program має правильну working directory.
- Process запускається від правильного системного користувача.
- Увімкнено autostart і продумано autorestart.
- Зупинка процесу коректно передає signal дочірнім processes.
- Worker, Reverb і SSR мають окремі журнали.
- Після зміни Supervisor config виконуються
rereadіupdate. - Після deployment довготривалі processes перезапускаються.
- Після restart перевіряється
supervisorctl status. - Після process check виконується окрема функціональна перевірка.
Що я залишила собі на майбутнє
- Розділяти HTTP runtime і довготривалі processes.
- Для worker, Reverb і SSR мати окремий життєвий цикл.
- Не змішувати process status із service health.
- Після deployment завжди оновлювати довготривалі processes.
- Перевіряти Reverb не тільки за статусом process, а й за мережевою доступністю.
- SSR перевіряти реальним HTML response.
- Queue worker перевіряти не лише за RUNNING, а й за фактичним виконанням задач.
- Не приховувати permission або environment problems запуском від root.
- Зберігати процеси достатньо незалежними, щоб один збій не вимагав перезапуску всього application stack.
Висновок
На одному production-сервері ICanUp одночасно працюють різні частини одного Laravel-застосунку: PHP-FPM, queue worker, Reverb та Inertia SSR.
Supervisor дав мені один зрозумілий спосіб керувати трьома довготривалими процесами: запускати їх після reboot, перезапускати після збою, оновлювати після deployment і бачити їхній поточний стан.
Але найважливіший урок був іншим: керування процесом і перевірка його функціональності - це різні рівні.
Worker може бути RUNNING, але не виконувати потрібну роботу. Reverb може бути RUNNING, але realtime усе одно потребує окремої перевірки. SSR може бути RUNNING, але конкретна сторінка все одно може падати під час server rendering.
Тому мій production-контракт простий: Supervisor тримає processes живими, а deployment і health checks доводять, що вони справді виконують свою роботу.