Успішний CI/CD pipeline ще не означає, що production після розгортання справді працює.
Команди можуть завершитися без помилки, файли можуть опинитися на сервері, а застосунок при цьому вже не відкривається, не бачить базу даних, не має зібраних frontend assets або залишився без queue worker.
Тому в ICanUp я розділяю дві події: код розгорнуто і нова версія перевірена на production.
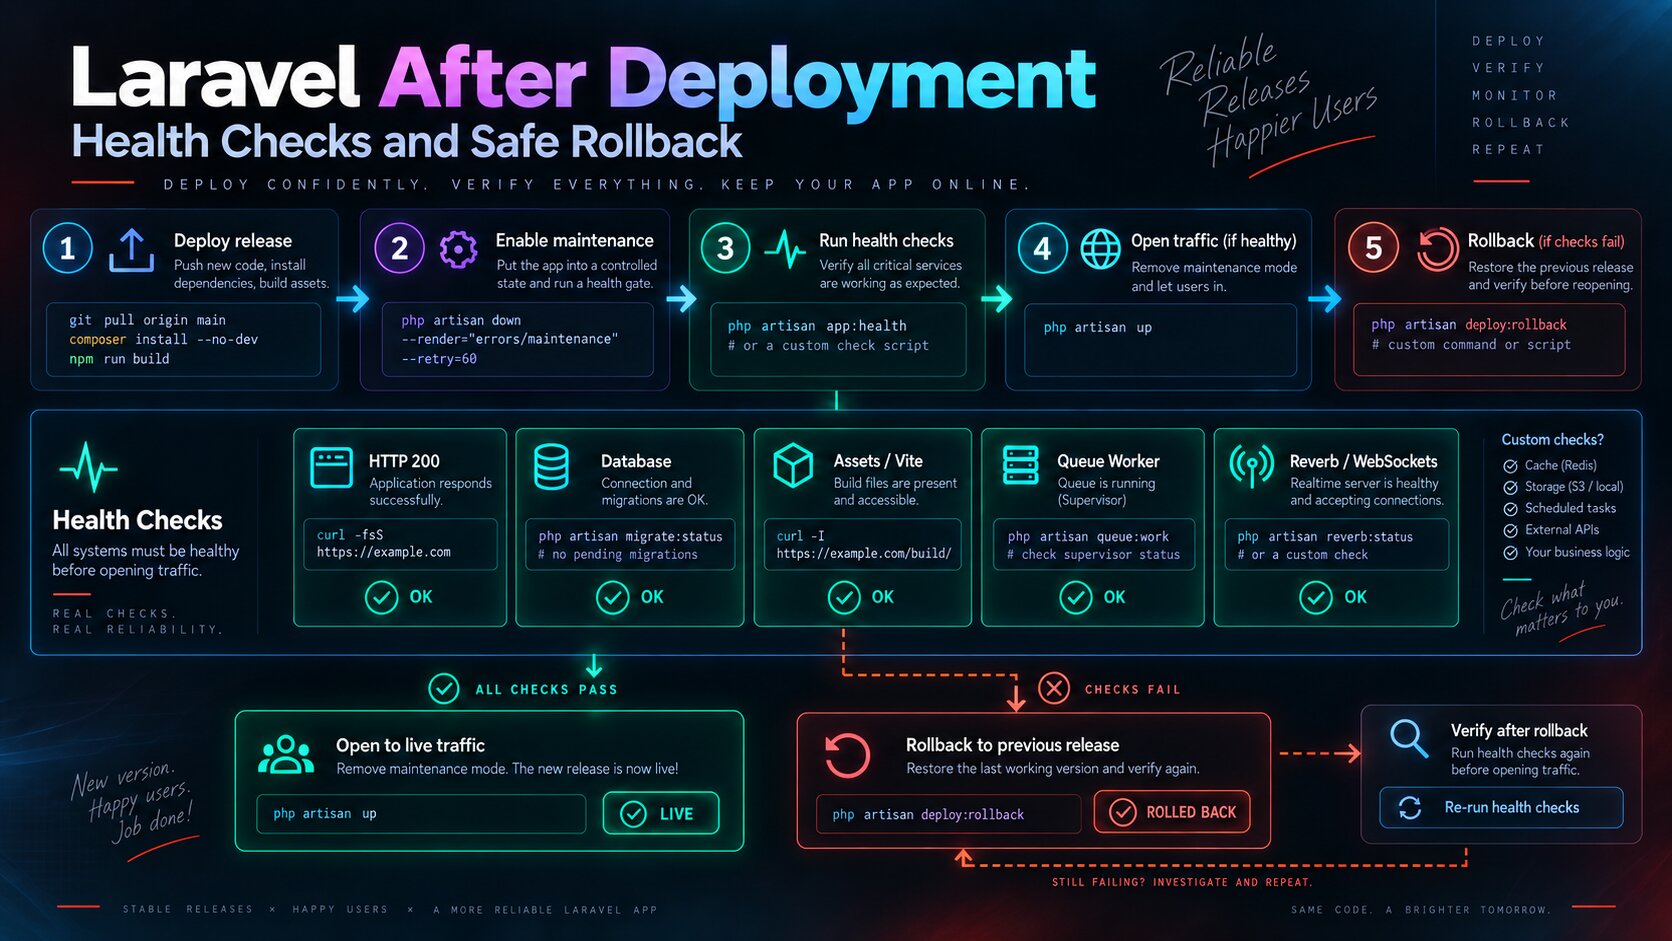
Проблема: deploy завершився, але це ще не доказ працездатності
До появи окремого післярозгортального контролю легко було орієнтуватися лише на код завершення deployment script.
Але цей код відповідає лише на питання, чи виконалися конкретні команди.
Він не гарантує, що користувач уже може відкрити сайт і що всі залежні служби працюють разом.
Що завершилося успішно | Чого це ще не доводить |
|---|---|
| Що Laravel може завантажитися |
| Що застосунок має доступ до БД |
Міграції | Що HTTP-відповідь коректна |
Збірка assets | Що worker і Reverb працюють |
Restart Supervisor | Що всі процеси справді перейшли в RUNNING |
Я зробила перевірку багаторівневою
Одна перевірка головної сторінки теж недостатня.
HTTP 200 може повернути Nginx або вже згенерована сторінка, тоді як queue worker, база даних або Reverb залишаються несправними.
Тому я перевіряю кілька рівнів окремо.
- Який commit фактично розгорнуто.
- Чи завантажується Laravel.
- Чи доступна база даних.
- Чи відповідає сайт через HTTP.
- Чи існують зібрані frontend assets.
- Чи працюють процеси Supervisor.
- Чи працює queue worker.
- Чи запущений Reverb і чи слухає потрібний порт.
Спочатку я фіксую commit, який розгортаю
Для відкату потрібно точно знати, яка версія працювала до deployment і яка версія встановлена зараз.
Фраза "повернути попередню версію" небезпечна, якщо попередня версія не має однозначного Git SHA або tag.
DEPLOYED_SHA="$(git rev-parse HEAD)" printf '%s\n' "$DEPLOYED_SHA"Цей SHA можна записати в deployment metadata або artifact, щоб після збою не визначати версію за часом файлів чи пам'яттю.
Laravel має окремо пройти перевірку завантаження
Наступний рівень - переконатися, що framework узагалі може завантажити застосунок у поточному оточенні.
Це дозволяє рано помітити помилки конфігурації, відсутній class, проблемний service provider або іншу помилку, яка виникає ще до нормальної обробки HTTP-запиту.
php artisan about > /dev/nullЗ’єднання з базою даних перевіряється окремо
Laravel може завантажитися навіть тоді, коли база даних недоступна або credentials для production неправильні.
Тому перевірка БД є окремим кроком.
php artisan tinker --execute='DB::connection()->getPdo();echo "Database OK\n";'У автоматизованому deployment для цього краще мати окрему мінімальну команду або health endpoint, але принцип залишається тим самим: перевіряти реальне з’єднання, а не лише наявність DB_* змінних.
HTTP-перевірка має падати разом із deployment
Після внутрішніх перевірок я дивлюся на застосунок так, як його бачить зовнішній клієнт.
Для CI/CD важливо не просто надрукувати HTTP status у лог, а повернути помилку, якщо контрольний URL недоступний.
HEALTH_URL="${HEALTH_URL:-https://icanup.com.ua/}" curl \ --fail \ --silent \ --show-error \ --location \ "$HEALTH_URL" \ > /dev/nullОпція --fail тут важлива. Без неї HTTP 500 можна випадково отримати як звичайну успішно виконану команду curl.
Frontend assets теж можуть зламати вже розгорнутий сайт
У Laravel з Vite backend може бути повністю справним, але користувач отримає сторінку без JavaScript або CSS, якщо build artifact відсутній або не відповідає коду.
Мінімальна серверна перевірка - переконатися, що Vite manifest існує.
test -s public/build/manifest.jsonЦе не замінює браузерний smoke test, але добре ловить грубий клас помилок, коли application code вже новий, а frontend build не потрапив на сервер.
Supervisor потрібно перевіряти після restart
Команда restart може завершитися, але окремий процес після запуску одразу впаде.
Тому після перезапуску я окремо дивлюся поточний стан керованих процесів.
sudo supervisorctl statusДля ICanUp тут важливі щонайменше queue worker, Reverb і SSR-процес.
Мені потрібен не сам факт наявності process configuration, а стан RUNNING після розгортання.
Queue worker перевіряю як окрему службу
Зламаний queue worker не обов'язково зробить головну сторінку недоступною.
Сайт може виглядати справним, але фонові задачі вже накопичуються в черзі.
Саме тому HTTP 200 не може бути єдиною післярозгортальною перевіркою.
sudo supervisorctl status \ | grep -E 'worker|RUNNING'Reverb потребує перевірки процесу і порту
Для WebSocket-служби недостатньо знати, що Supervisor спробував запустити процес.
Потрібно також переконатися, що служба справді слухає налаштований порт.
sudo supervisorctl status \ | grep -i reverb ss -lntПеревірки мають зупиняти pipeline, а не лише писати попередження
Якщо після deployment HTTP недоступний або Laravel не може завантажитися, зелений статус pipeline був би неправдивим.
Тому критичні перевірки повинні завершувати команду з помилкою.
set -euo pipefail php artisan about > /dev/null test -s public/build/manifest.json curl \ --fail \ --silent \ --show-error \ --location \ "$HEALTH_URL" \ > /dev/nullПорядок перевірок теж має значення
Я намагаюся спочатку запускати дешевші та точніші перевірки, а вже потім переходити до зовнішніх.
Так із логу швидше зрозуміло, на якому рівні виникла проблема.
1. Deployed commit SHA | v2. Laravel boot | v3. Database connection | v4. Frontend assets | v5. Supervisor processes | v6. Queue worker / SSR / Reverb | v7. HTTP check | v Production healthyКоли починається відкат
Відкат не повинен бути реакцією на будь-яке косметичне попередження.
Але для критичної помилки потрібне чітке рішення, а не десять хвилин ручного редагування production.
- Laravel не завантажується.
- Немає з’єднання з production database.
- Контрольний HTTP-запит повертає помилку.
- Немає потрібного Vite build.
- Критичний Supervisor process не переходить у RUNNING.
- Reverb або інша обов’язкова служба не запускається.
Відкат починається з відомого стабільного SHA
Я не хочу виправляти production копіюванням окремих старих файлів.
Потрібно повернути застосунок до конкретного Git state, який уже був відомий як працездатний.
PREVIOUS_SHA="<previous-stable-commit>" git fetch origin git reset --hard "$PREVIOUS_SHA"Rollback теж повинен пройти ті самі перевірки
Повернути Git SHA недостатньо.
Після відкату я знову запускаю той самий набір перевірок працездатності.
Інакше немає доказу, що попередню версію справді відновлено коректно.
New deploy | vHealth check failed | vRollback to known stable SHA | vRun deployment steps again | vRun the SAME health checks | +-- fail -> investigate / recovery | +-- pass -> service restoredМіграції роблять rollback складнішим
Найнебезпечніша помилка - вважати, що повернення Git commit автоматично повертає і базу даних.
Код можна повернути за кілька секунд, але destructive migration могла вже видалити column, змінити дані або зробити старий код несумісним із новою schema.
Code rollback і database rollback - це різні операції.
Зміна | Наскільки простий відкат |
|---|---|
Новий nullable column | Зазвичай старий код може його ігнорувати |
Нова таблиця | Часто сумісна зі старим кодом |
Rename column | Може одразу зламати старий код |
Drop column | Git rollback не повертає втрачені дані |
Data migration | Потрібна окрема стратегія відновлення |
Перед ризикованою міграцією потрібен backup
Якщо production migration потенційно змінює або видаляє дані, rollback procedure має починатися ще до deployment.
Перед такою зміною потрібна перевірена резервна копія, а не надія на php artisan migrate:rollback.
Я віддаю перевагу сумісним у часі змінам schema
Найбезпечніший deployment - той, де новий і попередній код певний час можуть працювати з однією schema.
Наприклад, спочатку можна додати новий nullable column, розгорнути код, перенести дані, а видалення старого column зробити окремим пізнішим release.
Такий підхід значно спрощує відкат застосунку.
Я не змішую maintenance mode і health checks
Сторінка технічних робіт вирішує іншу проблему: що бачить користувач у момент, коли застосунок тимчасово недоступний під час deployment.
Перевірка працездатності відповідає на інше питання: чи можна вважати нову версію готовою до нормальної роботи.
Ці механізми доповнюють один одного, але не замінюють.
Це продовження мого реального CI/CD процесу
Сам процес побудови deployment pipeline я раніше описувала в матеріалі про реальний Laravel CI/CD pipeline у ICanUp.
Післярозгортальні перевірки стали наступним рівнем: pipeline має не тільки доставити код, а й довести, що розгорнута версія працездатна.
Мій короткий production checklist
- Зберегти SHA попередньої стабільної версії.
- Розгорнути новий commit.
- Перевірити завантаження Laravel.
- Перевірити реальне з’єднання з базою даних.
- Перевірити Vite manifest і потрібні assets.
- Перезапустити керовані процеси.
- Переконатися, що queue worker, SSR і Reverb працюють.
- Перевірити потрібний Reverb port.
- Виконати зовнішню HTTP-перевірку.
- Зберегти SHA успішно розгорнутої версії.
- При критичній помилці виконати документований відкат.
- Після відкату повторити весь набір перевірок.
Що я б не робила
- Не вважала б успішний git pull доказом успішного deployment.
- Не обмежувалася б тільки HTTP 200.
- Не перевіряла б Supervisor лише командою restart.
- Не залишала б commit SHA невідомим.
- Не відновлювала б production ручним копіюванням окремих файлів.
- Не прирівнювала б Git rollback до database rollback.
- Не запускала б ризиковану destructive migration без резервної копії.
- Не використовувала б migrate:rollback як єдину стратегію відновлення даних.
- Не завершувала б rollback без повторної перевірки працездатності.
Deployment завершений не тоді, коли код потрапив на сервер, а тоді, коли я можу довести, що розгорнута версія справді працює.
Що я залишила собі на майбутнє
- Перевіряти production багаторівнево, а не одним HTTP-запитом.
- Знати точний SHA поточної і попередньої стабільної версії.
- Перевіряти Laravel boot і database connection окремо.
- Перевіряти assets після кожного deployment.
- Перевіряти фактичний стан Supervisor processes після restart.
- Queue worker, SSR і Reverb вважати частиною працездатності застосунку.
- Робити критичні health checks такими, що можуть зупинити pipeline.
- Після rollback запускати той самий набір перевірок.
- Вважати database recovery окремою задачею від Git rollback.
- Для ризикованих migrations мати backup до початку змін.
Висновок
У ICanUp післярозгортальна перевірка перетворила deployment з набору команд на керований процес.
Я хочу знати не тільки те, що новий commit опинився на сервері. Мені потрібно підтвердити завантаження Laravel, доступ до БД, наявність assets, стан queue worker, SSR, Reverb і зовнішню HTTP-відповідь.
Якщо критична перевірка не проходить, має бути відомий попередній стабільний SHA і документований шлях повернення.
А для міграцій я тримаю окреме правило: відкат коду не повертає автоматично стан бази даних.


