Під час production-розгортання у ICanUp є короткий проміжок, коли код, Composer dependencies, міграції, кеші та довготривалі процеси можуть оновлюватися не одночасно.
Якщо в цей момент пропускати звичайний трафік, користувач може потрапити саме між двома станами застосунку.
У найкращому випадку він просто оновить сторінку. У гіршому - побачить випадковий 500 Internal Server Error.
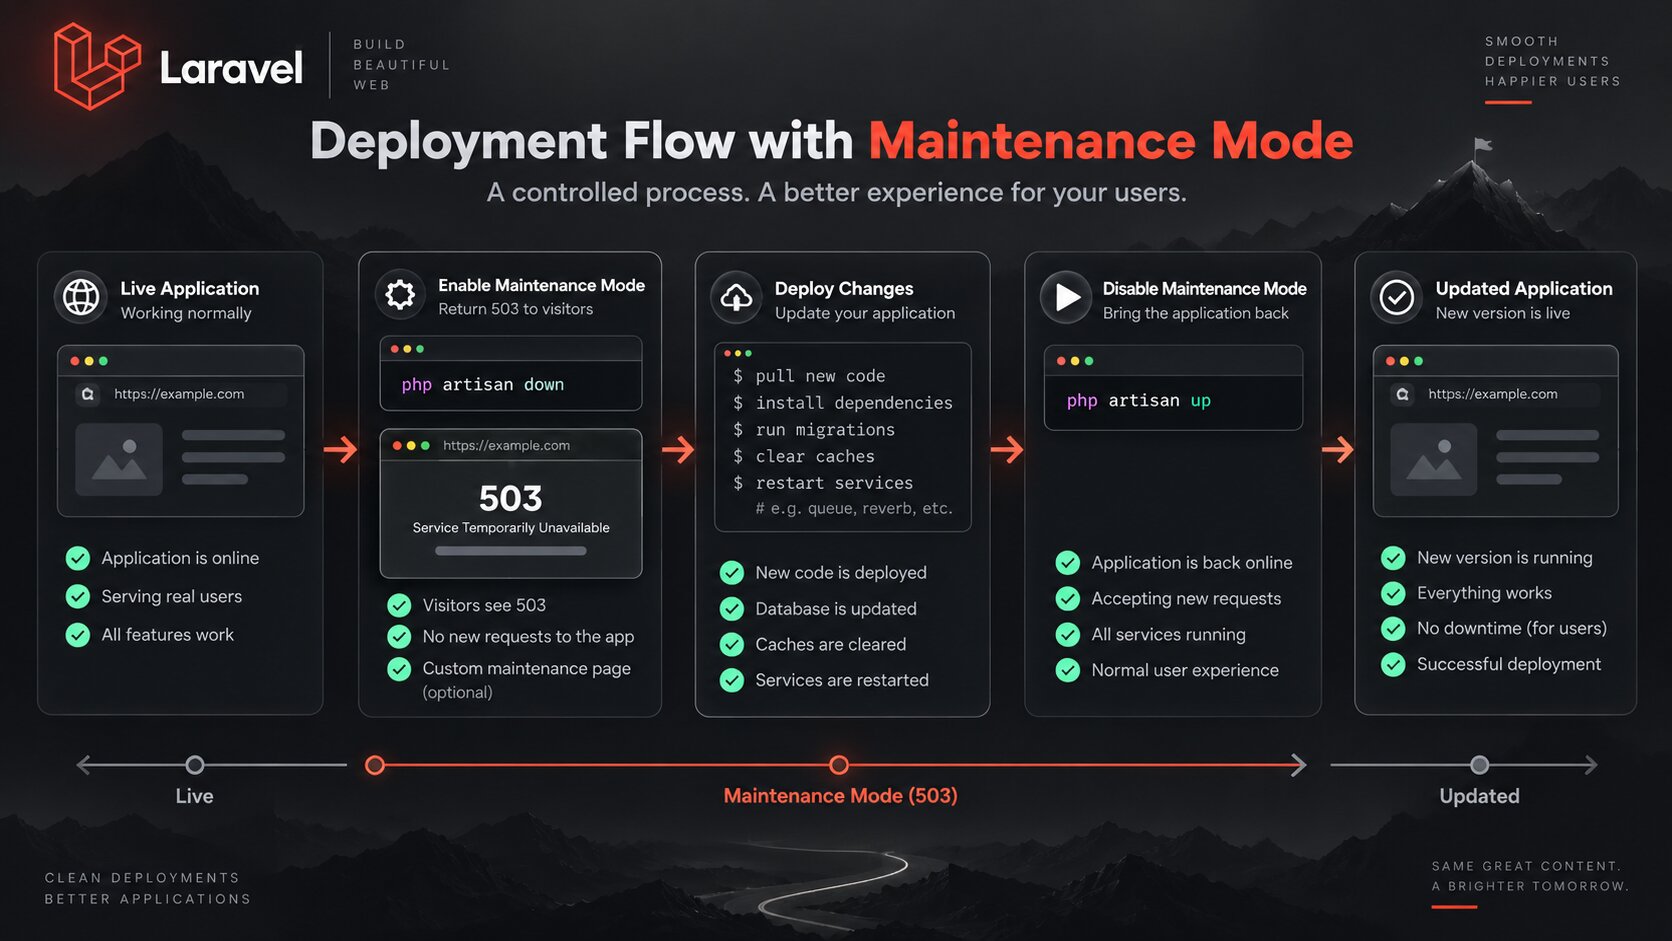
Тому на критичній частині розгортання я навмисно переводжу сайт у режим технічних робіт (maintenance mode) і повертаю контрольований HTTP 503 Service Unavailable.
Проблема не в самому deployment, а в проміжному стані
Окрема команда розгортання може бути правильною, але всі команди разом не виконуються атомарно.
Git уже може містити новий код, а vendor ще старий. Міграція вже могла змінити schema, а Laravel cache ще відповідає попередній версії. Новий frontend build може ще не бути встановлений.
Для користувача це виглядає не як "deployment in progress". Для нього це просто зламана сторінка.
Етап | Що може бути тимчасово неузгоджене |
|---|---|
Оновлення Git revision | Новий application code зі старими dependencies |
Composer install | Код і vendor можуть бути з різних версій |
Frontend build | HTML уже новий, а assets ще старі або відсутні |
Міграції | Код і database schema можуть короткий час не збігатися |
Перебудова кешів | Laravel може використовувати застарілу configuration або routes |
Restart processes | Worker, Reverb або SSR можуть ще працювати зі старим кодом |
500 і 503 мають різний зміст
500 Internal Server Error означає, що сервер намагався обробити звичайний запит і не зміг.
503 Service Unavailable означає інше: сервіс тимчасово недоступний і сервер повідомляє про це навмисно.
Під час контрольованого розгортання саме другий варіант описує реальний стан системи.
HTTP status | Що він означає в цьому випадку |
|---|---|
500 | Користувач потрапив у помилковий стан застосунку |
503 | Застосунок навмисно тимчасово закритий для оновлення |
Я вмикаю режим технічних робіт до критичних змін
Режим технічних робіт має бути активований до заміни application code, dependencies та інших критичних частин.
Якщо ввімкнути його вже після composer install або migrations, частина ризикованого вікна все одно залишиться відкритою.
php artisan down \ --render=maintenance \ --retry=60 \ --refresh=15У цьому варіанті для мене важливі три параметри:
--render=maintenance- використати попередньо підготовлене представлення maintenance page.--retry=60- передати клієнту інформацію, через який час варто повторити запит.--refresh=15- дозволити сторінці періодично оновлюватися під час короткого технічного вікна.
Чому для мене важливий --render
Найгірший варіант maintenance page - сторінка, яка сама залежить від тих частин Laravel, які зараз оновлюються.
Якщо під час composer install або перебудови cache maintenance response потребує нормального завантаження всього застосунку, вона може зламатися разом із ним.
Тому я використовую попередньо підготовлену сторінку через --render.
Що бачить користувач
Я не показую stack trace, назву невдалої команди або інші внутрішні деталі.
Користувачеві достатньо зрозуміти, що сайт тимчасово оновлюється і потрібно спробувати ще раз трохи пізніше.
Тривають технічні роботи Ми оновлюємо сайт і незабаром повернемося.Будь ласка, спробуйте оновити сторінку через кілька хвилин.Під час maintenance я не зупиняю Nginx і PHP-FPM
Щоб повернути контрольований HTTP 503, web stack повинен продовжувати приймати запити.
Тому я не використовую зупинку Nginx або PHP-FPM як спосіб "закрити" сайт на час deployment.
У такому випадку користувач отримав би timeout, connection refused або помилку proxy замість зрозумілої maintenance response.
Критична частина розгортання проходить під 503
Enable maintenance mode | vUpdate code | vInstall Composer dependencies | vInstall / activate frontend build | vRun migrations | vSynchronize application stateПоки ці кроки не завершилися, я не хочу відкривати звичайний public traffic.
Типовий production flow у мене виглядає так
php artisan down \ --render=maintenance \ --retry=60 \ --refresh=15 git fetch origingit reset --hard origin/main composer install \ --no-dev \ --no-interaction \ --prefer-dist \ --optimize-autoloader php artisan migrate --force Найважливіше правило: помилка не повинна автоматично виконати artisan up
Сам факт, що deployment script завершується, ще не означає, що сайт потрібно повернути користувачам.
Якщо критична команда завершилася помилкою, поточний application state може бути неповним.
У такому випадку я залишаю maintenance mode активним до виправлення проблеми або rollback.
Deployment command failed | vDo NOT expose current application state | vKeep HTTP 503 active | +-- fix problem | +-- rollback | vverify againЧому звичайний trap може бути небезпечним
У shell script легко написати cleanup handler, який завжди виконає php artisan up при завершенні.
Для тимчасових файлів це хороший підхід. Для production traffic - не завжди.
Якщо deployment упав після зміни schema або dependencies, автоматичне відкриття сайту в cleanup може показати користувачам саме той пошкоджений стан, від якого maintenance mode мав захищати.
cleanup_on_failure() { echo "Deployment failed." echo "Maintenance mode remains active."} trap cleanup_on_failure ERRMaintenance mode вимикається лише після перевірок
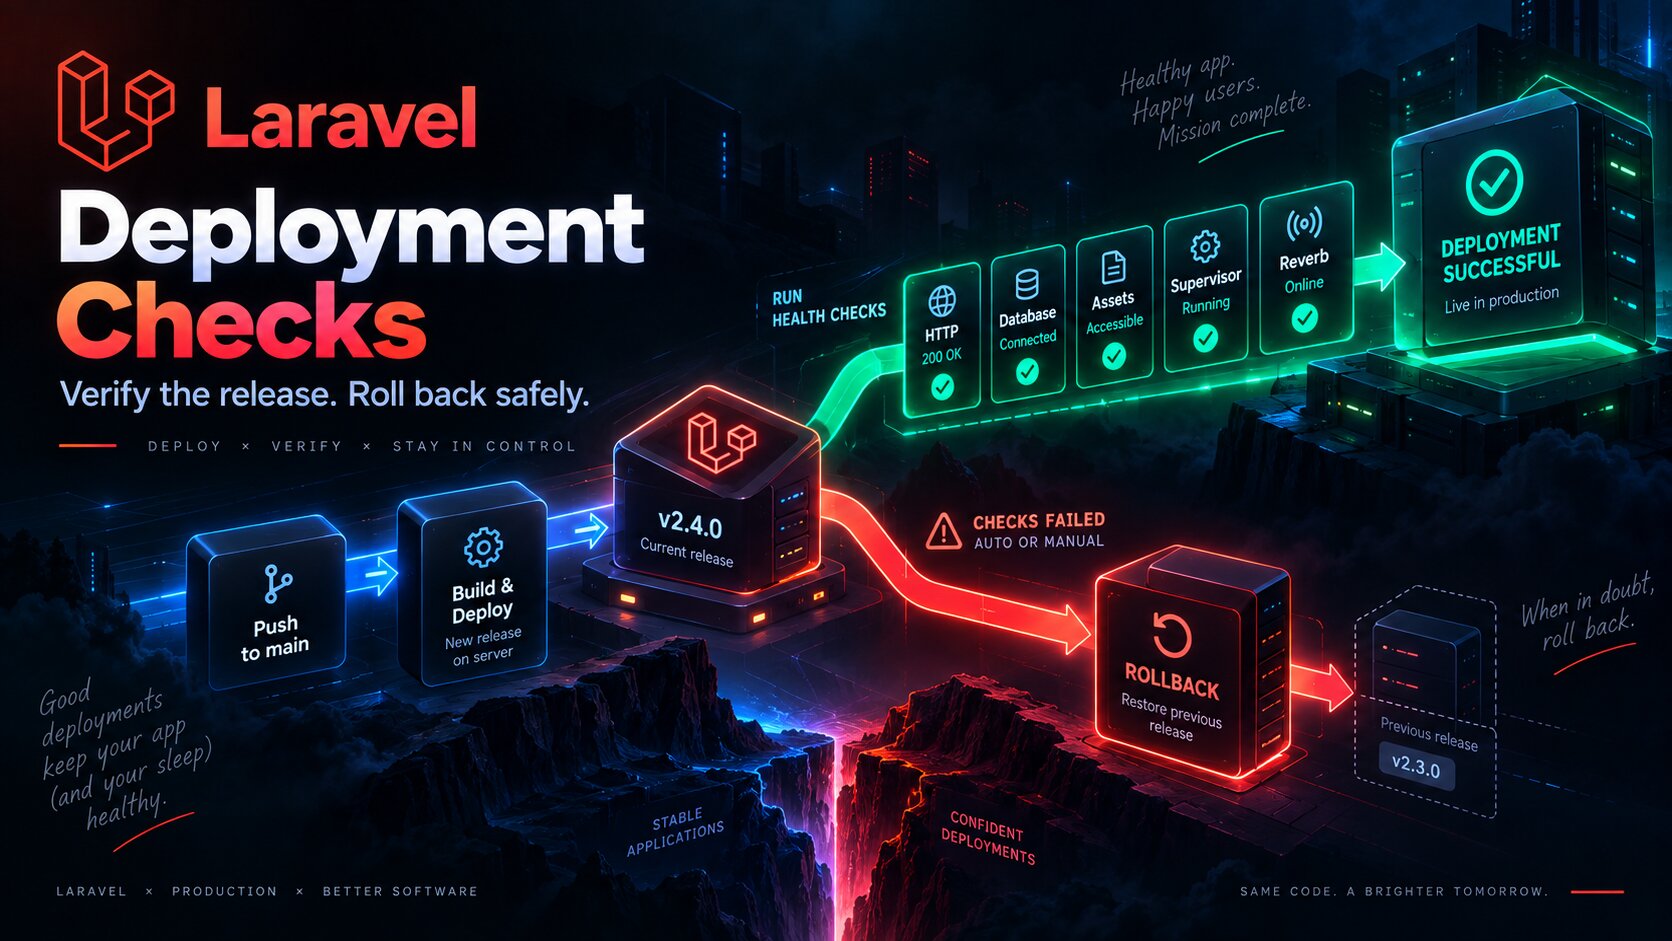
Я не використовую php artisan up одразу після останньої deployment command.
Спочатку перевіряю, чи застосунок узагалі готовий приймати нормальний трафік.
- Laravel успішно завантажується.
- Міграції завершилися без помилки.
- Laravel caches перебудовані.
- Frontend assets присутні.
- Queue worker працює.
- Reverb працює.
- SSR process працює.
- Supervisor не показує критичних process failures.
sudo supervisorctl statusПісля цього я повертаю звичайний traffic
php artisan upАле навіть після artisan up deployment для мене ще не завершений.
Фінальна HTTP-перевірка виконується вже після artisan up
Після повернення звичайного трафіку я виконую зовнішній HTTP check.
Він перевіряє вже не maintenance page, а реальний public application.
curl \ --fail \ --silent \ --show-error \ --location \ https://icanup.com.ua/ \ > /dev/nullОпція --fail потрібна, щоб HTTP 500 не виглядав для shell як успішно виконана команда.
Якщо фінальна перевірка не проходить, сайт знову закривається
Є ще один важливий edge case: усі deployment commands пройшли, artisan up виконаний, але зовнішня перевірка показала проблему.
У такому випадку я не залишаю сайт відкритим лише тому, що pipeline уже майже завершився.
if ! curl \ --fail \ --silent \ --show-error \ --location \ https://icanup.com.ua/ \ > /dev/nullthen php artisan down \ --render=maintenance \ --retry=60 \ --refresh=15 exit 1fiRetry-After теж має значення
HTTP 503 може містити Retry-After, щоб клієнт або crawler розумів, що недоступність тимчасова.
Для короткого контрольованого deployment це точніше, ніж поводитися так, ніби сторінка зламалася назавжди.
У Laravel я задаю цей інтервал через --retry.
503 не повинен перетворюватися на довгу аварію
Режим технічних робіт не є виправданням для довгого простою.
Його задача - зробити короткий небезпечний перехід передбачуваним.
Якщо maintenance mode залишається активним надовго, це вже окремий operational incident, який потрібно діагностувати.
SSR, Reverb і worker теж входять у повернення застосунку
У сучасному Laravel-застосунку HTTP 200 не описує весь стан системи.
У ICanUp після deployment потрібно також повернути в правильний стан queue worker, Reverb і Inertia SSR.
Саме тому перезапуск і перевірка Supervisor processes відбуваються ще до завершення maintenance window.
Maintenance page і health check вирішують різні задачі
Механізм | Його задача |
|---|---|
Maintenance mode | Не пустити користувача у проміжний або несправний стан |
503 page | Коректно пояснити тимчасову недоступність |
Process checks | Переконатися, що довготривалі processes запущені |
HTTP health check | Перевірити реальний application response після відкриття сайту |
Rollback | Повернути відому стабільну версію, якщо нову відновити швидко не вдається |
Це частина CI/CD, а не ручна команда на сервері
Для мене maintenance mode має сенс лише тоді, коли він є частиною передбачуваного deployment flow.
Я не хочу щоразу вручну згадувати, коли запускати artisan down, коли artisan up і що перевірити між ними.
Загальну побудову цього процесу я описувала у матеріалі про реальний Laravel CI/CD pipeline.
Що я не роблю
- Не залишаю звичайний public traffic відкритим під час критичного оновлення application state.
- Не показую користувачам випадкові 500, якщо недоступність насправді запланована.
- Не зупиняю Nginx або PHP-FPM лише заради maintenance window.
- Не будую maintenance page на складній логіці, яка сама може зламатися під час deployment.
- Не виконую
artisan upавтоматично після будь-якого failure. - Не вважаю завершення останньої deployment command доказом працездатності.
- Не відкриваю сайт до перевірки Supervisor processes.
- Не завершую deployment без фінальної HTTP-перевірки.
- Не залишаю невдалу фінальну перевірку з відкритим public traffic.
Мій короткий checklist
- Підготувати просту maintenance page.
- Увімкнути maintenance mode до критичних змін.
- Повернути HTTP 503, а не 200.
- Передати
Retry-Afterчерез--retry. - Виконати оновлення code, dependencies, migrations і caches.
- Перезапустити довготривалі processes.
- Перевірити Supervisor status.
- При failure залишити maintenance mode активним.
- Виконати
artisan upлише після внутрішніх перевірок. - Після відкриття сайту виконати зовнішній HTTP health check.
- Якщо він не проходить, знову повернути сайт у maintenance mode.
Під час розгортання краще навмисно показати користувачу короткий 503, ніж випадково відкрити йому напівоновлений застосунок.
Що я залишила собі на майбутнє
- Розглядати maintenance mode як межу між стабільною старою та стабільною новою версією.
- Вмикати 503 до початку критичних змін.
- Використовувати попередньо підготовлену maintenance page.
- Не покладатися на повне завантаження Laravel для сторінки технічних робіт.
- Не відкривати сайт автоматично після невдалого deployment.
- Перевіряти довготривалі processes до повернення public traffic.
- Після
artisan upвиконувати окрему зовнішню перевірку. - При невдалій фінальній перевірці повертати maintenance mode.
- Тримати recovery і rollback procedure окремо від звичайного успішного flow.
Висновок
У ICanUp режим технічних робіт став для мене не декоративною сторінкою, а частиною production safety.
Його задача проста: не дозволити користувачу потрапити в проміжний стан між старою та новою версією застосунку.
На критичний період сайт навмисно повертає 503 Service Unavailable. Код, dependencies, migrations, caches, queue worker, Reverb та SSR оновлюються за закритим traffic.
Якщо щось завершується помилкою, maintenance mode залишається активним. Якщо внутрішні перевірки проходять, сайт відкривається, після чого виконується ще одна зовнішня HTTP-перевірка.
Для мене правильне розгортання - це не відсутність кількох секунд 503. Це відсутність випадкового пошкодженого стану, який користувач узагалі може побачити.