22 жовтня 2026 року в Admin Analytics ICanUp знову з’явився різкий сплеск переглядів.
На той момент було 527 загальних переглядів. 474 із них припадали на Німеччину, 481 - на mobile devices, 506 - на Chrome. Для posts було 400 переглядів, але лише 65 deduplicated views.
Близько 07:00 за Києвом графік різко пішов угору.
Зовні це могло виглядати як хвиля звичайних mobile readers. Але після інцидентів 8-9 жовтня я вже не хотіла робити висновки за User-Agent або однією analytics metric.
Аналітика дала сигнал, але не відповідь
Найпомітнішими були дві речі: концентрація трафіку в одному профілі device/browser і великий розрив між raw post views та deduplicated views.
Сам по собі такий розрив не доводить автоматизацію. Я детальніше розбираю це в статтю про розрив між total views і deduplicated views. Тут він був лише причиною перейти від дашборду до логів сервера.
Перш ніж читати logs, я вирівняла часові зони
Admin АналітикаEurope/Kyiv Nginx access logsUTC Вікно дослідженняспочатку перетворення, потім фільтраціяЦе маленький крок, але без нього легко шукати "потрібну хвилину" не там.
Аналітика показувала час реєстрації відвідувача у Europe/Kyiv, а Nginx access logs використовували UTC. Я спочатку перерахувала потрібний window, і потім тільки починала агрегувати запити.
За три години було зафіксовано 1600 HTTP-запитів, але основна частина активності припала на значно коротший проміжок часу
У період із 06:00 до 09:00 за київським часом Nginx зафіксував 1600 HTTP-запитів до різних віртуальних хостів на сервері.
Найбільший сплеск стався о 07:44, коли за одну хвилину надійшло 623 запити.
Основний клієнт надіслав 740 запитів приблизно за три хвилини, з яких 621 - протягом однієї хвилини. За цей час він звернувся до 129 різних URL-адрес.
User-Agent виглядав звичайно, поведінка - ні
Дані про клієнта - Android 10- Chrome 131- Мобільний пристрій Зафіксована поведінка - 740 запитів приблизно за 3 хвилини- 621 запит за 1 хвилину- 129 різних URL-адрес- Від 40 до 51 запиту до окремих нових статейОсновний User-Agent виглядав як звичайний Android Chrome Mobile.
Але окремі нові articles запитувалися по 40-51 разу за дуже короткий interval. Для мене саме request pattern був сильнішим сигналом, ніж рядок браузера.
Це продовження висновку з попередній матеріал про трафік, який виглядає людським, але поводиться як bot: User-Agent описує те, ким клієнт себе називає, а не доводить, що перед нами людина.
Розподіл HTTP-статусів дав більше інформації, ніж сама кількість запитів.
Основний клієнт | HTTP-статус | Кількість запитів || ----------- | ----------------- || 499 | 441 || 301 | 224 || 200 | 33 || 403 | 32 || 404 | 10 || Усього | 740 |441 запит завершився зі статусом 499. Для Nginx це означає, що клієнт закрив з’єднання до того, як сервер завершив надсилання відповіді.
Тому 740 HTTP-запитів не означають, що 740 сторінок були успішно завантажені та прочитані. Так само ці запити не обов’язково відповідають 740 переглядам у Laravel Analytics.
Лише 33 запити цього клієнта завершилися зі статусом 200. Значна частина решти припала на перенаправлення, перервані клієнтом з’єднання, заборонені запити та звернення до неіснуючих сторінок.
Я окремо аналізувала HTTP-запити, перегляди сторінок у Laravel Analytics і перегляди без повторів
HTTP-запит до Nginx | vМоже завершитися перенаправленнямабо статусом 403 / 404 / 499 Запит до Laravel | vМоже створити або не створитизапис про перегляд в аналітиці Перегляд у Laravel Analytics | vМоже бути зарахований або не зарахованийЦе також важливо для подальшого розслідування того, як аналітика розрізняє звичайних відвідувачів і ботів.
Автоматизований клієнт, який використовує User-Agent мобільного Chrome, може бути помилково визначений як звичайний браузер, якщо механізм розпізнавання ботів спирається лише на цей заголовок.
Але на основі зведених показників я не можу достовірно стверджувати, що всі 740 запитів потрапили саме до категорії Human у Laravel Analytics.
Для цього потрібна окрема перевірка: яка версія механізму розпізнавання ботів працювала на робочому сервері, які запити фактично дійшли до Laravel і які з них створили записи про перегляди.
Під час одного сплеску активності було зафіксовано трафік із кількох незалежних джерел
Після групування запитів стало зрозуміло, що не весь підозрілий трафік надходив від одного клієнта.
Основний клієнт із високою активністю: 740 запитів до 129 різних URL-адрес.
Окремий сканер: 227 запитів до 224 URL-адрес, із яких 222 завершилися зі статусом
404.Окремий пошуковий робот, який представлявся Sogou: 163 запити до 160 URL-адрес.
Інші клієнти: окремі спроби перевірити відомі вразливості старих версій PHP, PHPUnit і CGI.
Я не об’єдную всю цю активність в «одну атаку», оскільки журнали сервера не дають для цього достатніх доказів. Збіг за часом ще не означає, що всі запити надходили від одного джерела або були організовані однією особою.
Одна з перших гіпотез про 503 виявилася неправильною
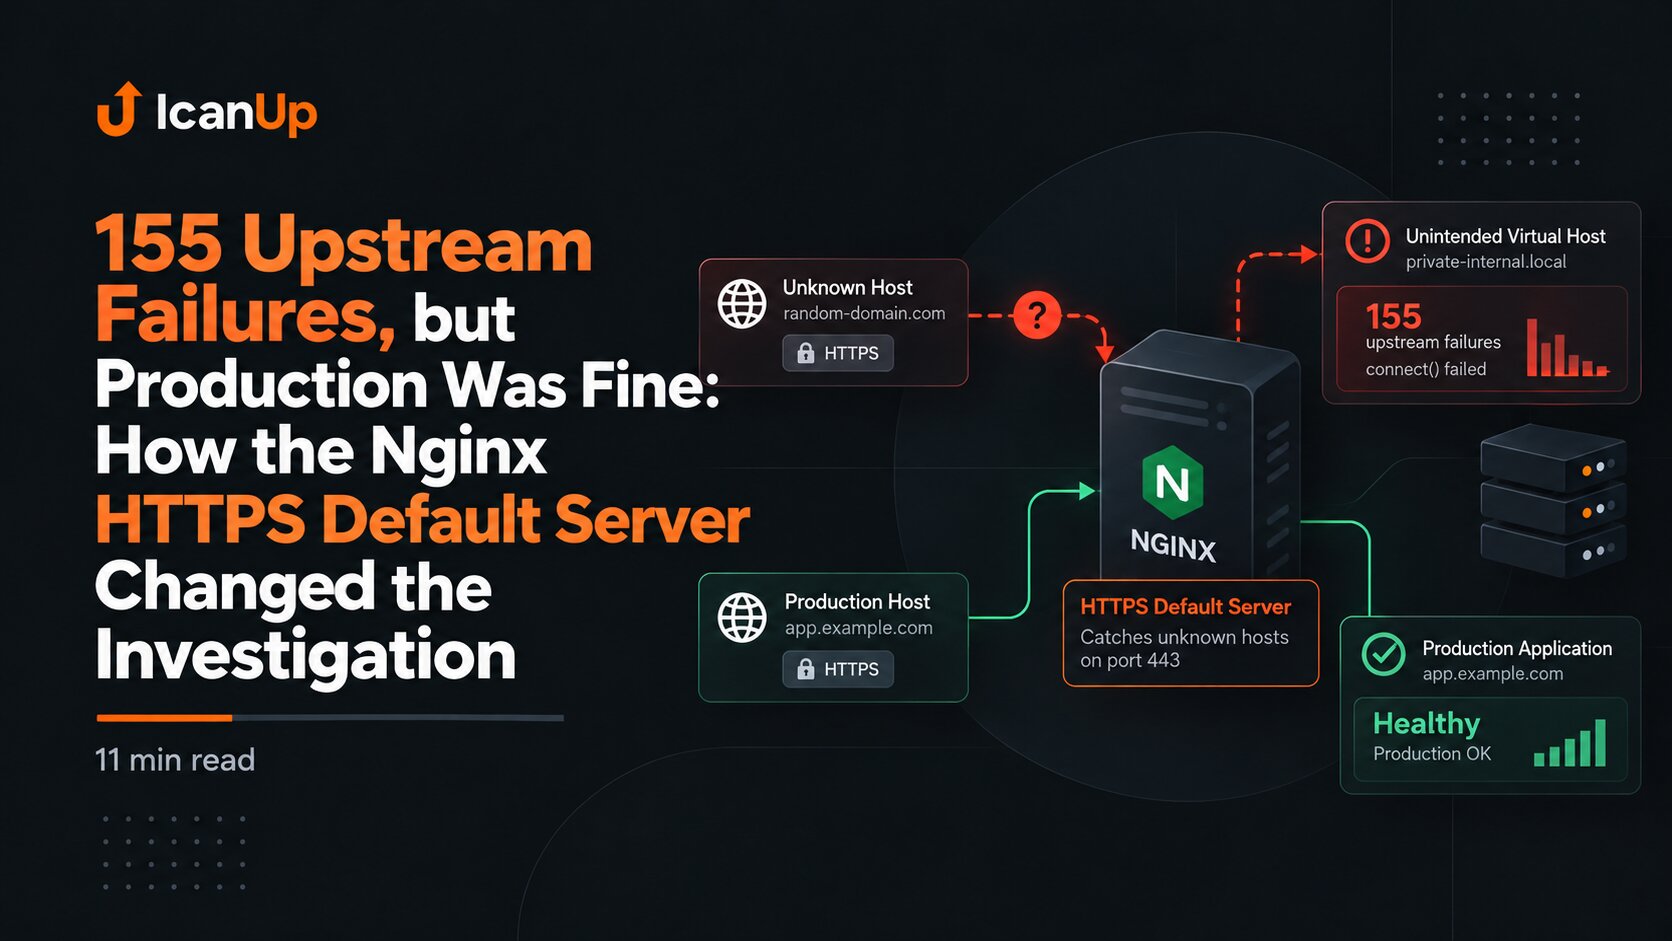
Під час того самого періоду розслідування я виявила 155 помилок upstream connection refused і спочатку припустила, що велика кількість запитів могла вплинути на доступність основного робочого застосунку.
Однак журнал помилок не підтвердив цього припущення. Усі 155 помилок стосувалися іншого віртуального хоста з окремим сервером застосунку, тоді як основний сайт продовжував відповідати на запити.
Цю історію я винесла в окремий матеріал, оскільки вона стосується іншої теми: налаштування стандартного HTTPS-сервера, маршрутизації між віртуальними хостами та того, чому спільний журнал помилок Nginx не можна аналізувати без урахування того, до якого саме сайту належить кожен запис.
Fail2ban уже працював, але вирішував іншу задачу
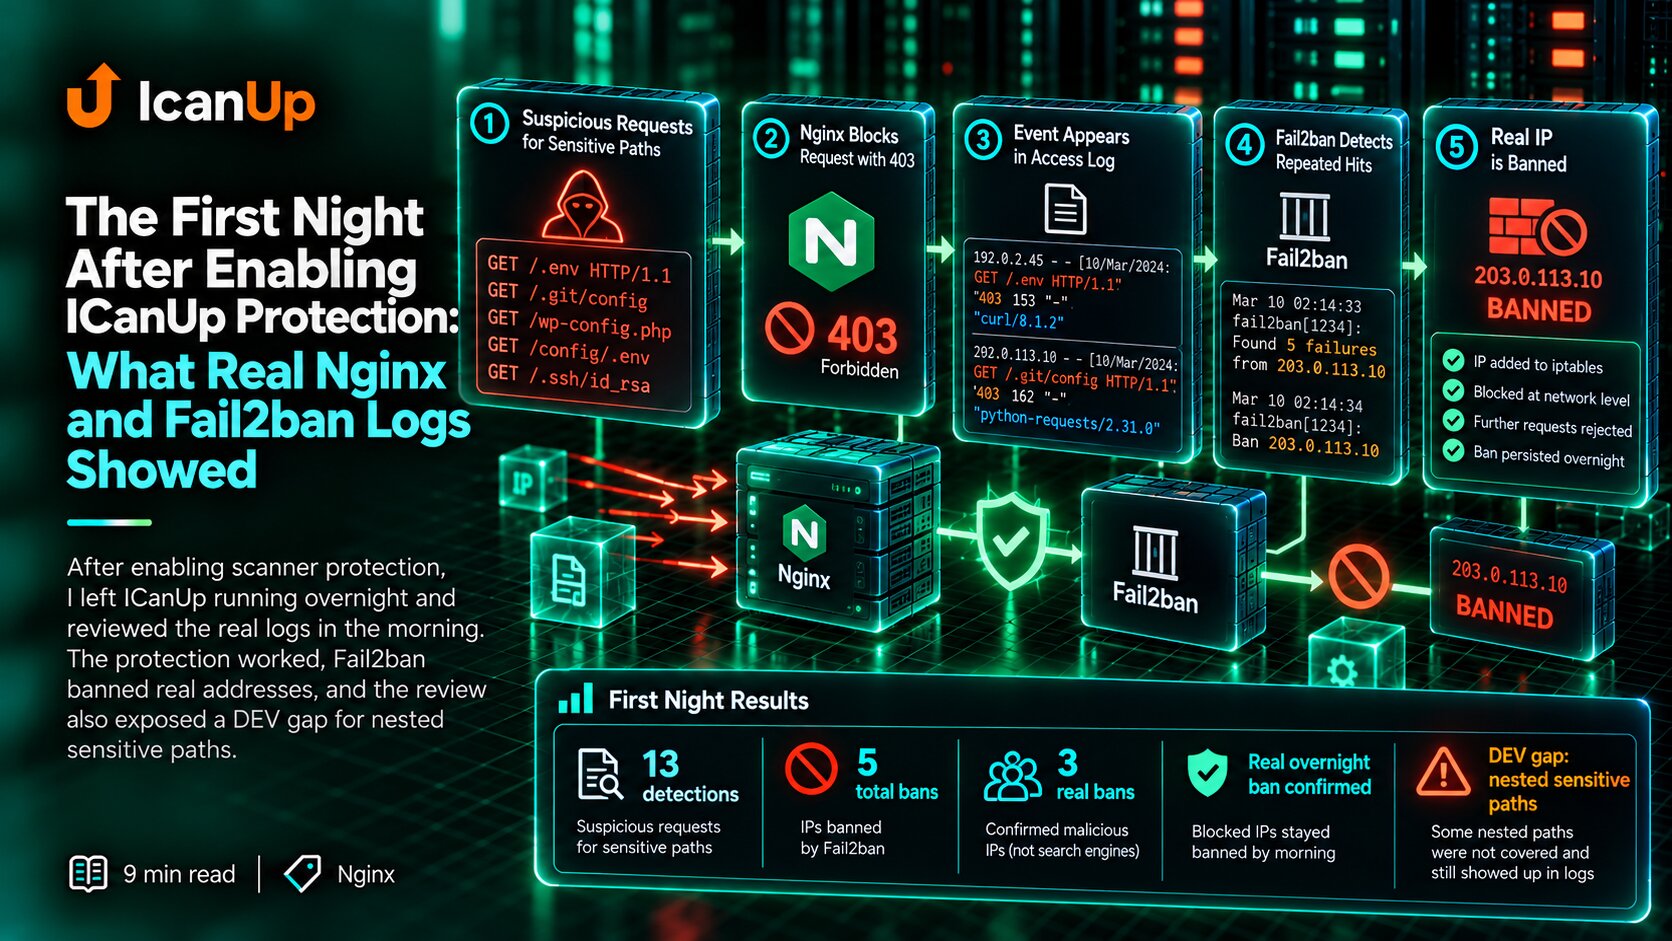
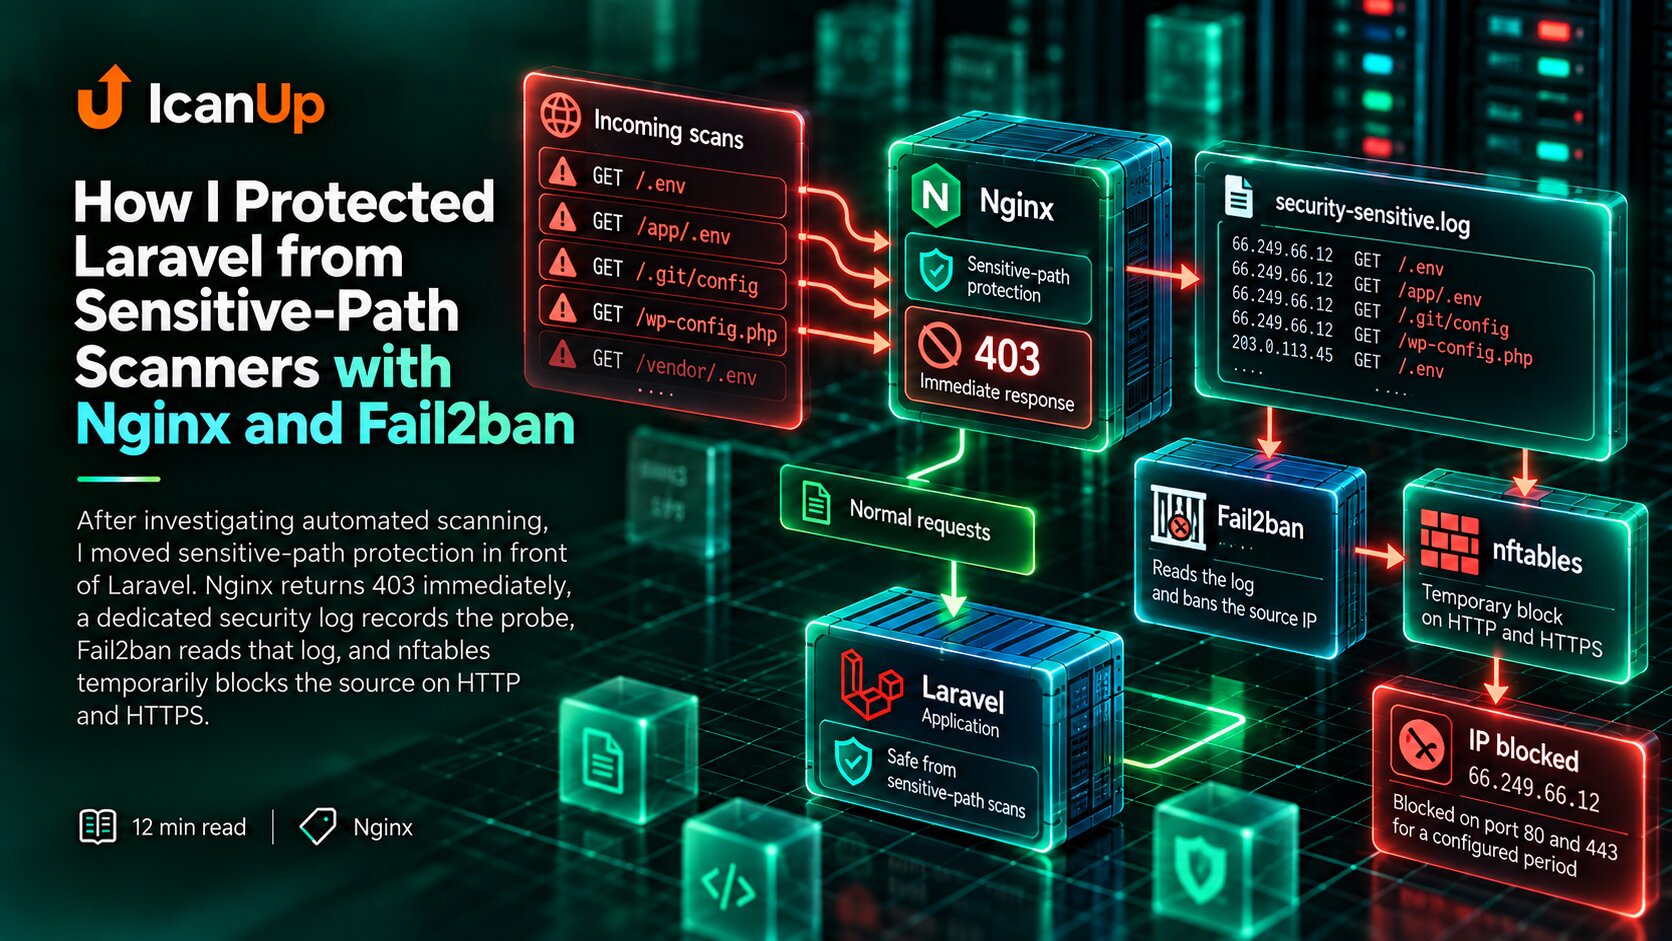
До цього інциденту на сервері вже працювали правила Nginx для виявлення підозрілих запитів до шляхів із потенційно конфіденційними даними та Fail2ban, який блокував підтверджених сканерів через брандмауер.
Наприкінці перевірки Fail2ban показував 41 спрацювання фільтра, 9 блокувань загалом і 5 активних блокувань. IP-адреса основного клієнта з високою активністю також уже була в списку заблокованих.
Тому висновок «Fail2ban не працює» був би неправильним. Він працював і застосовував блокування відповідно до налаштованих правил.
Захист від запитів до вразливих шляхів і обмеження частоти запитів протидіють різним типам підозрілої активності
Сканер, що звертається до підозрілих шляхів /.hidden-config/old-admin-probe/archive-probe => блокування за URL-шляхом=> запис у журналі безпеки=> підстава для блокування через Fail2ban Клієнт із надмірною кількістю запитів /posts/article-a/posts/article-b/posts/article-cСаме тут стала зрозумілою прогалина в захисті.
Правила перевірки URL-шляхів добре виявляють сканерів, які звертаються до очевидно підозрілих ресурсів. Але клієнт може надіслати сотні запитів до цілком допустимих маршрутів /posts/... і при цьому не порушити жодного правила захисту від звернень до вразливих або конфіденційних шляхів.
Детальніше саму sensitive-path модель я описувала в окремий матеріал про Nginx і Fail2ban для sensitive-path scanners. Новий інцидент показав, що цього рівня захисту недостатньо, коли клієнт надсилає надмірну кількість запитів до звичайних URL-адрес.
Я не стала блокувати всю країну, певну версію Chrome або весь трафік із мобільних пристроїв
90% переглядів із Німеччини виглядали незвично. Дані Android 10 / Chrome 131 повторювалися. З однієї IP-адреси надходила надмірна кількість запитів.
Але жодна з цих ознак окремо не є достатньою підставою для визначення клієнта як бота.
За географічним розташуванням може стояти VPN, хостинг, проксі-сервер або реальний читач. User-Agent легко підробити. Одну IP-адресу можуть використовувати кілька користувачів.
Тому правила блокування я хотіла будувати на основі фактичної поведінки клієнта, а не однієї ненадійної ознаки.
Наступним шаром став Nginx rate limiting
Я додала окрему limit_req_zone для обмеження частоти динамічних запитів до робочого сайту та застосувала її до обробника PHP-запитів.
У публічній статті я свідомо не вказую точні порогові значення, які використовуються на робочому сервері. Вони залежать від звичайного обсягу трафіку, характеру короткочасних сплесків, можливостей серверної інфраструктури та наявності спільного проксі-сервера перед основним сервером.
Для пояснення важливіший сам принцип налаштування обмежень, а не конкретні значення.
limit_req_zone $binary_remote_addr zone=app_dynamic:10m rate=<tested-rate>; location ~ \.php$ { limit_req zone=app_dynamic burst=<tested-burst> nodelay; limit_req_dry_run on; limit_req_status 429; limit_req_log_level warn; # existing PHP handling}Ключове рішення - спочатку dry-run, а не реальне блокування
Я не хотіла боротися з ботами ціною помилкового блокування звичайних читачів.
Обмеження частоти запитів за IP-адресою має очевидний ризик: кілька реальних користувачів можуть виходити в інтернет через одну адресу завдяки NAT, корпоративній мережі або мобільному оператору. Так само односторінкові застосунки (SPA), завантаження ресурсів і паралельні запити можуть створювати короткочасні сплески активності.
Тому спочатку я ввімкнула режим limit_req_dry_run on. У цьому режимі Nginx виявляє перевищення встановлених обмежень і записує їх у журнали, але не відхиляє запити.
Після зміни я перевіряла не лише nginx -t
Nginx config validation PASSReload PASS Production 200Development 401Private service 401Unknown HTTPS hostname rejected Dry-run over-limit eventsat verification time 0Конфігурація успішно пройшла перевірку та повторне завантаження, а всі віртуальні хости продовжили правильно обробляти запити.
На момент перевірки режим dry-run не зафіксував нових перевищень. Це теж важливий результат: я не можу стверджувати, що нове обмеження частоти запитів уже зупинило попереднього клієнта.
Обмеження було налаштоване після інциденту, а нового сплеску подібної активності на момент перевірки ще не було.
Посилення захисту робочого сервера я виконувала так, щоб зміни можна було безпечно скасувати
Перед редагуванням конфігурацій Nginx я створила резервні копії. Після внесення змін перевірила правильність конфігурації, повторно завантажила Nginx і лише потім перевірила, як сервер обробляє HTTP-запити.
Коли з’явилося попередження через відмінності в параметрах HTTPS listen, я не залишила його «на потім», а узгодила налаштування та повторно виконала nginx -t.
Для мене посилення захисту не повинно створювати нових ризиків і невизначеності в роботі основного сайту.
Частину питань я свідомо залишила відкритими
Після розслідування інциденту я все ще не мала достатньо даних, щоб достовірно відповісти на кілька запитань.
Яка саме версія механізму розпізнавання ботів працювала на робочому сервері під час сплеску активності?
Які із численних HTTP-запитів фактично дійшли до Laravel?
Які з цих запитів створили записи про перегляди в аналітиці?
Чи можна на основі наявних зведених даних довести, що ця активність вплинула саме на показники звичайних відвідувачів?
Тому я не видаляла історичні дані аналітики й не змінювала автоматично їхню класифікацію без достатніх доказів.
Що цей інцидент змінив у моїй моделі захисту
User-Agentзвичайного браузера не доводить, що запити надходять від реальної людини.HTTP-запити, перегляди в Laravel Analytics і перегляди без повторів - це різні рівні обліку активності.
HTTP-статус
499не можна вважати підтвердженням успішного завантаження та прочитання сторінки.Спільні журнали Nginx потрібно аналізувати з урахуванням конкретного віртуального хоста.
Захист від звернень до підозрілих URL-шляхів і обмеження частоти запитів вирішують різні завдання.
Країна, версія Chrome або одна IP-адреса самі по собі не є достатньою підставою для визначення клієнта як бота.
Нові правила обмеження запитів краще спочатку перевіряти в режимі
dry-run, без фактичного блокування.Висновки, для яких недостатньо доказів, потрібно залишати непідтвердженими.
Захист став сильнішим не через одне правило, а через кращі межі між сигналами
Найкориснішим результатом цього інциденту для мене стало не конкретне обмеження частоти запитів.
Я чіткіше розділила сигнали аналітики, фактичні дані із журналів Nginx, захист від сканування підозрілих шляхів, блокування через брандмауер і обмеження надмірної кількості запитів.
740 запитів за три хвилини показали, що навіть справно працюючий Fail2ban не гарантує повного захисту від усіх видів автоматизованої активності. Тому потрібен був додатковий рівень захисту, вплив якого на звичайних користувачів слід спочатку перевірити, перш ніж вмикати фактичне блокування.
Захист робочого сервера став надійнішим, коли я перестала шукати одне універсальне правило й почала окремо враховувати різні типи підозрілої активності.