Під час розслідування нового traffic spike я побачила в Nginx error log 155 записів upstream connection refused.
Перша гіпотеза була очевидною: можливо, масові requests створили навантаження, через яке основний production application почав відповідати 503.
Це звучало правдоподібно, але виявилося неправильним.
Усі 155 зафіксованих upstream failures належали іншому virtual host. Основний production site у цей час продовжував працювати.
Чому 155 помилок 503 спочатку виглядали серйозно
Час збігався з незвичайним великим трафіком. У тому самому investigation window Nginx бачив сотні запитів від автоматизованих клієнтів.
На фоні цього connection refused природно прочитати як "backend не витримав".
Але кореляція в часі ще не означає кореляцію в причині.
Я перестала рахувати errors і почала читати їх контекст
Не зупиняйтеся на: відмовлено у з'єднанні з висхідним потоком Також визначте: ім'я серверазапитуваний хостшлях запитуціль висхідного потокупозначку часуклієнтаКлючовим стало не саме повідомлення connection refused, а те, до якого upstream Nginx намагався підключитися.
Після групування стало видно: усі 155 помилки вели до бекенду іншого сервісу, який тимчасово не слухав свій локальний upstream.
Production Laravel бекенд не був джерелом цих 155 failures.
Наступне питання було складнішим: чому публічні сканери взагалі потрапили в цей віртуальний хост
Сам бекенд був локальним. Але локальний upstream не робить сервіс приватним автоматично.
Якщо Nginx має публічний HTTPS віртуальний хост, який проксить реквести до цього upstream, зовнішній клієнт взаємодіє не з локальним портом напряму, а з Nginx.
Тобто питання приватності треба ставити на публічній точці входу, а не тільки на адресу прив'язки бекенда.
В HTTPS не було явного default_server
Надходить HTTPS-запит відоме ім'я хоста? | +-- так -> відповідний віртуальний хост | +-- ні -> HTTPS-сервер за замовчуванням Немає явного default_server? | vперший відповідний сокет прослуховування може стати сокетом за замовчуваннямУ конфігурації не було окремого HTTPS catch-all із default_server.
Першим віртуальний хост для відповідного HTTPS лістенера був саме приватний сервіс. Коли scanner звертався до публічного IP або використовував невідомий hostname, Nginx міг обрати цей server block як default.
Саме тому частина зовнішнього автоматичного трафіку опинилася в сервісі, який я не очікувала бачити в цьому розслідуванні.
Це не означало успішний злам
Важливо не перебільшувати результат.
Я встановила, що публічні запити могли маршрутизуватися до неочікуваного віртуального хоста і що його бекенд у частині випадків був недоступний.
Я не знайшла докази успішного виконання шкідливого коду або компромісу самого сервісу.
Перша зміна - явний універсальний HTTPS
server { listen 443 ssl default_server; server_name _; ssl_reject_handshake on;}Мета цього блоку сервера проста: невідомий HTTPS hostname не повинен випадково успадковувати віртуальний хост, специфічний для програми.
ssl_reject_handshake on дозволяє відхилити handshake ще до маршрутизації запиту у приватний застосунок.
Друга зміна - окремий контроль доступу для приватного сервісу
location / { auth_basic "Restricted"; auth_basic_user_file /path/to/htpasswd; proxy_pass http://private_backend;}Сервер за замовчуванням вирішує проблему unknown-host routing. Але він не замінює контролю доступу для правильного hostname.
Тому самому сервісу я додала Basic Auth. Тепер навіть клієнт, який знає валідний hostname, спочатку проходить окрему межу автентифікації.
Дефолтний сервер і Basic Auth вирішують різні проблеми
Невідоме ім'я хоста | vHTTPS сервер_за_замовченням Телефон відхилено Відоме ім'я приватного хоста | v приватний віртуальний хост | vПісля зміни я перевірила кожен очікуваний шлях доступу
Production очікується -> 200 Development очікується -> 401 Приватний сервіс без облікових данихочікується -> 401 Приватний сервіс після автентифікаціїочікується -> відповідь програми Невідоме ім'я хоста HTTPSочікується -> доступ TLS відхиленоДля приватного сервісу після успішної Basic Auth кореневий роут повертав 404. Це було очікувано: автентифікація пройшла, але застосунок не визначав /.
Цей відмінність теж важлива. 401 означає контроль доступу, 404 після автентифікації - уже роутинг застосунку.
Валідація Nginx має бути чистою, не просто успішною
Після першої зміни перевірка конфігурації Nginx проходила, але залишала warning через різні параметри listen 443 ssl http2 для server blocks на одному socket.
Я вирівняла параметри й повторила nginx -t, доки валідація не стала чистою.
Налаштування Production не варто завершувати станом "працює, але warning залишимо".
Зміни конфігурації я робила з бекапом і rollback path
1. скопіювати поточну конфігурацію2. відредагувати одну межу3. nginx -t4. перезавантажити5. перевірити публічну поведінку6. перевірити захищену поведінку7. зберегти копію відкату, доки не стане стабільноюЦе був фікс безпеки, але я не хотіла, щоб сам фікс став outage.
Тому кожна зміна мала rollback copy, валідацію і перевірку очікуваного статус коду після перезавантаження.
Захист сканера не замінює правильну virtual-host межу
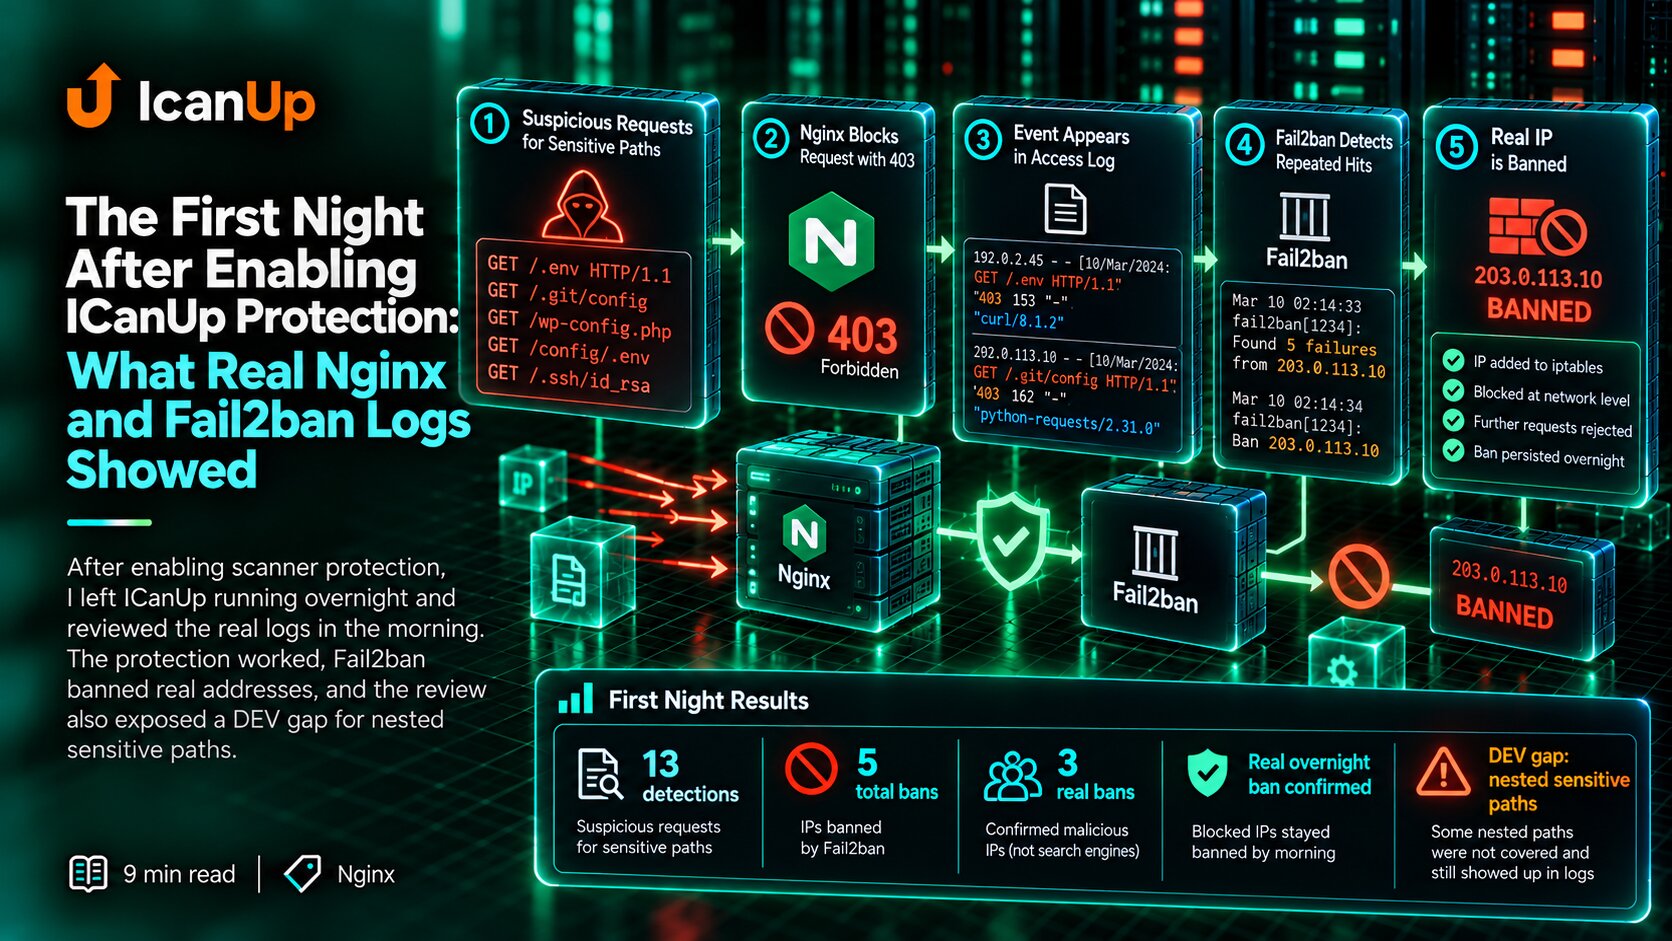
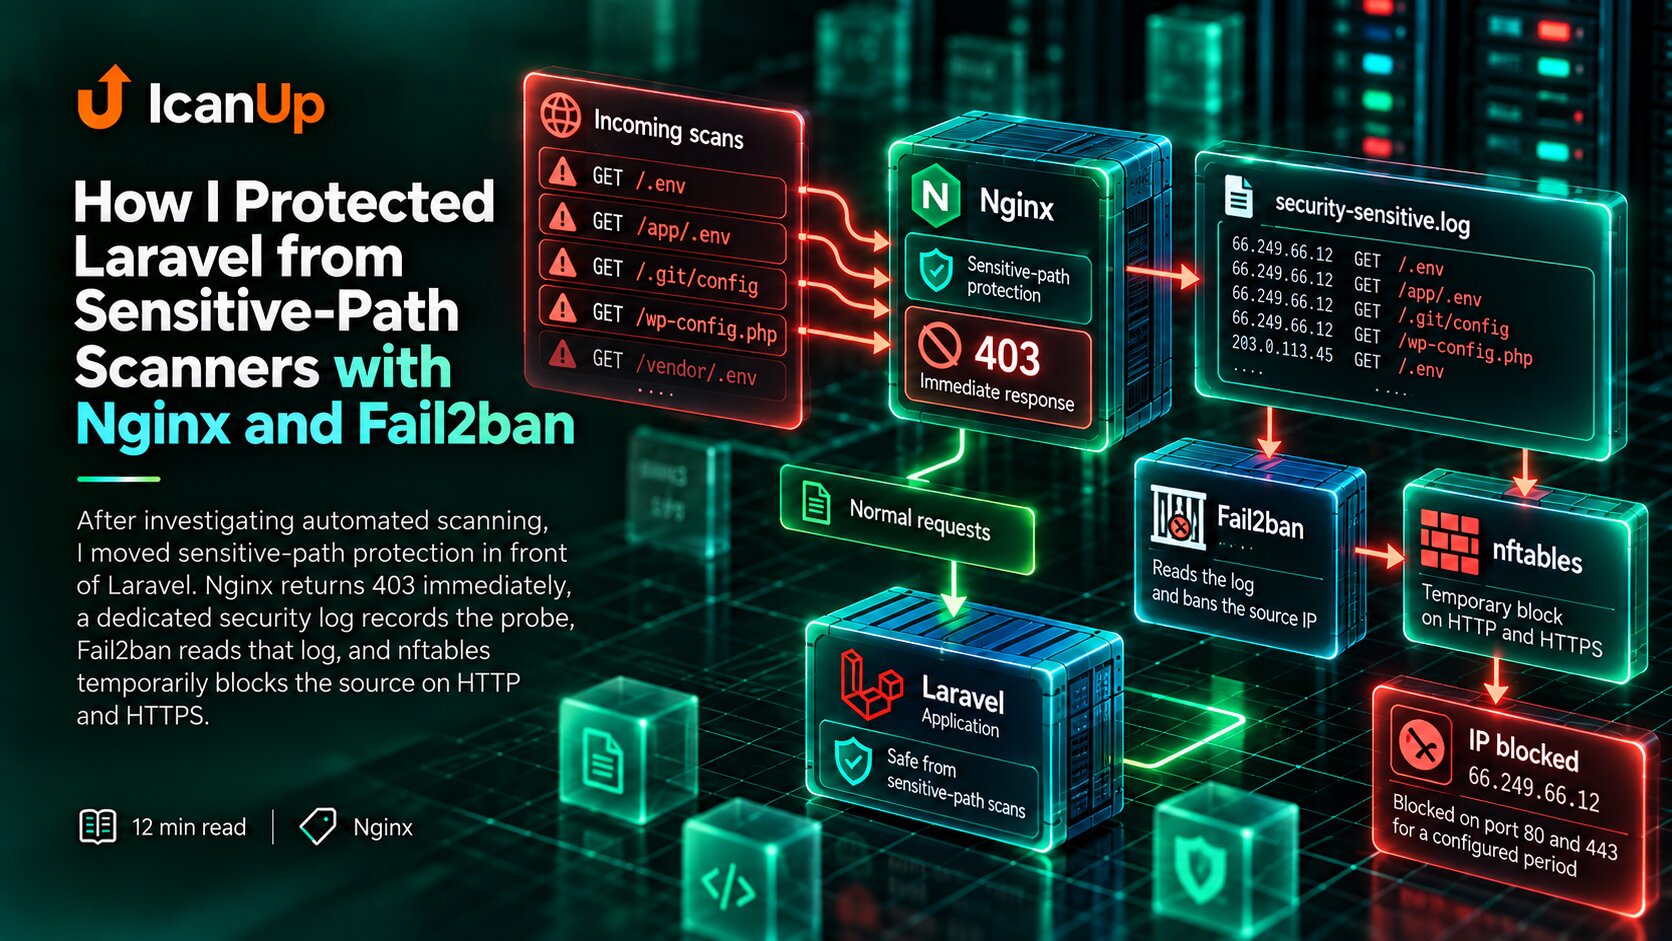
До цього на сервері вже працювали path-based правила і Fail2ban, які я описувала в матеріалі про Nginx і Fail2ban для sensitive-path scanners.
Вони добре вирішують питання підозрілих шляхів. Але якщо unknown-host запит уже потрапив у неправильний віртуальний хост, це інша проблема.
Саме тому рівні захисту не варто сприймати як взаємозамінні.
Початковий сигнал трафіку і першопричинавиявилися різними речами
Поштовхом до розслідування був автоматичний трафік, схожий на випадки з попередньому матеріалі про автоматизований трафік із browser-like User-Agent.
Але конкретні 503 не були доказом того, що саме цей трафік "поклав production". Вони вивели мене на окрему слабкість конфігурації маршрутизації віртуального хоста HTTPS.
Це хороший приклад, чому під час розслідування інциденту не можна дозволяти першій правдоподібній історії стати фінальним висновком.
Що я тепер перевіряю, коли бачу upstream помилки у спільних Nginx логах
Якому віртуальному хосту належить error?
Який upstream реально був недоступний?
Чи production застосунок у цей час справді повертав невдачі?
Який server block є HTTPS дефолтним для невідомих hostnames?
Що відбувається при direct-IP або unknown-host запитах?
Чи приватний сервісмає власний контроль доступу?
Чи
nginx -tпроходить без warnings?Чи перевірені всі очікувані результати HTTP/TLS після перезавантаження?
Чи є rollback path для зміна конфігурації?
155 errors змінили не доступність, а моє розуміння межі
На початку розслідування 155 upstream невдачі виглядали як можливий симптом production відключення.
Після розбору стало зрозуміло, що основний застосунок працював, а помилки належали іншому віртуальному хосту, який отримував зовнішній трафік через неявну HTTPS дефолтну поведінку сервера.
Виправленням стало не "лікування production", а правильне оформлення межі: явний дефолтний сервер для невідомих хостів і окремий контроль доступу приватного сервісу.
Спільний log показує, що помилка сталася десь у Nginx. Він не доводить, який застосунок впав, доки ми не встановимо контекст.