У багатьох системах є дані, які не є первинною правдою, але потрібні для швидкої роботи.
Це можуть бути лічильники, денормалізовані підсумки, проєкції, пошукові індекси, кешовані агрегати або допоміжні таблиці для читання.
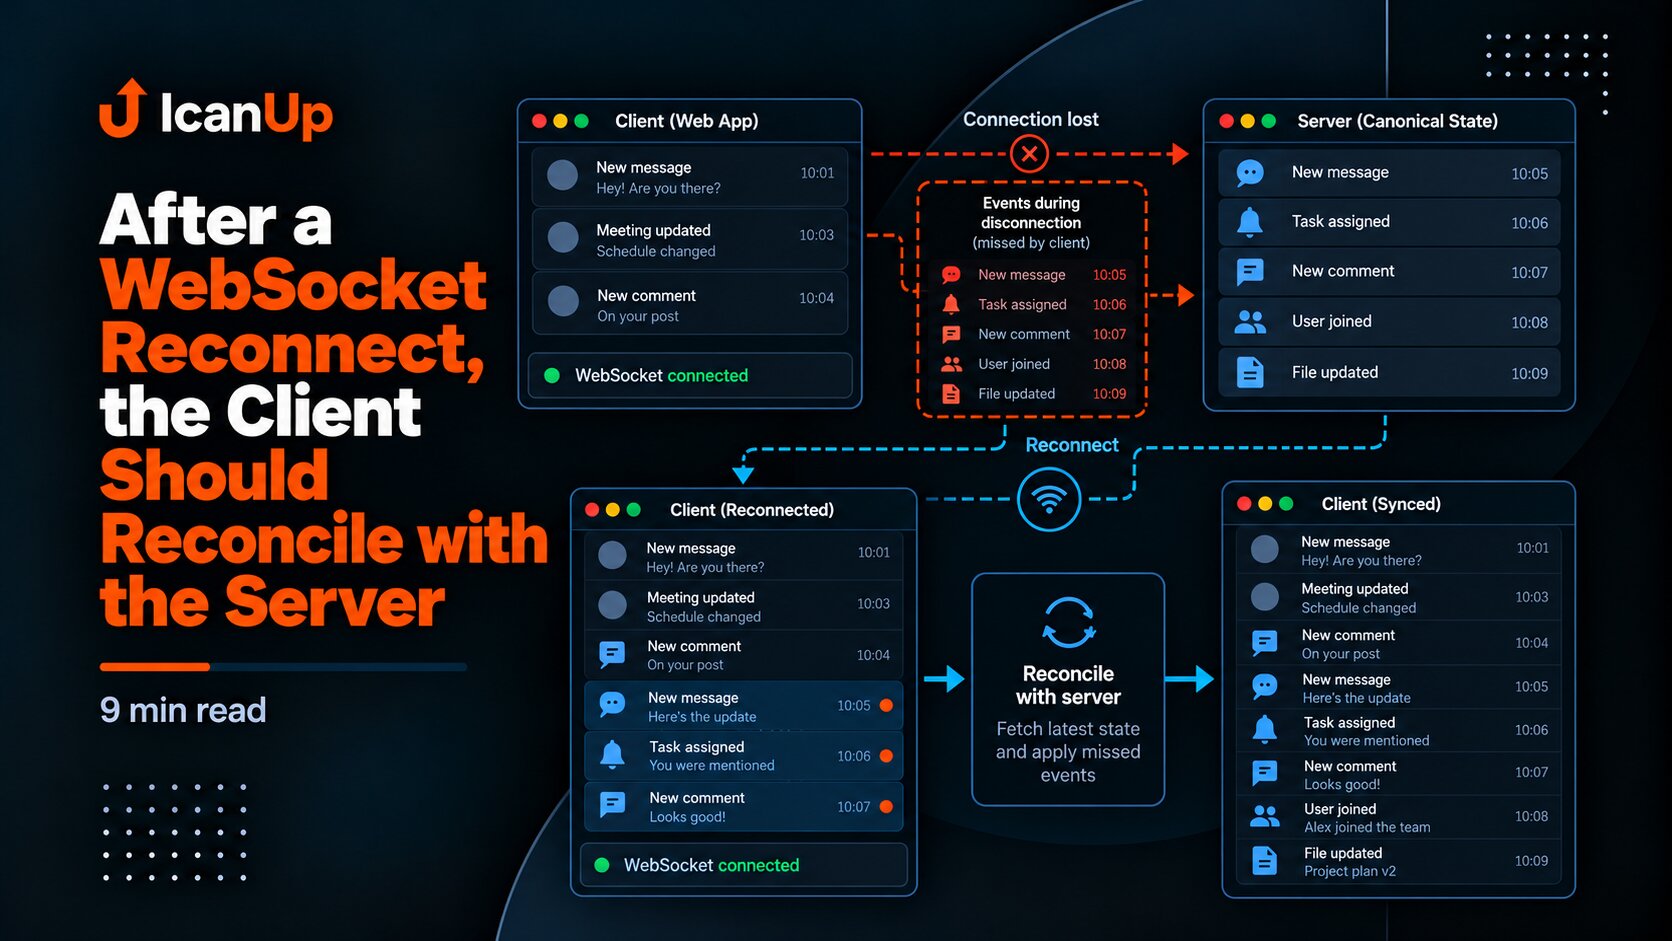
Поки все працює правильно, вони майже непомітні. Але після пропущеної події, збою черги, помилки в коді або невдалого розгортання похідний стан може розійтися з канонічними даними.
Якщо система не має штатного способу це перевірити й виправити, команда відновлення з’являється вже під час інциденту - поспіхом і без достатніх гарантій.
Спочатку треба чітко розділити канонічні й похідні дані
Відновлення можливе лише тоді, коли зрозуміло, з чого саме треба відтворювати стан.
Наприклад, кількість непрочитаних повідомлень може бути похідною від самих повідомлень і записів про прочитання. Пошуковий індекс - від основних сутностей. Денний підсумок - від окремих операцій.
Якщо похідне поле починає містити унікальну інформацію, якої більше ніде немає, воно вже перестає бути безпечно відновлюваним.
Корисний шлях має чотири явні етапи
canonical data -> recalculate expected state -> compare with stored state -> repair if neededВажливо не стрибати одразу до запису нового значення.
Спочатку система повинна вміти обчислити очікуваний стан без змін. Потім порівняти його з тим, що збережено. І лише після цього - виконати контрольоване виправлення.
Так одна й та сама логіка може використовуватись для діагностики, моніторингу, ручної перевірки й самого відновлення.
Перерахунок повинен бути окремою чистою операцією
final class RecalculateUnreadCount{ public function handle( User $user, ): int { return Message::query() ->forUser($user) ->unread() ->count(); }}Такий сервіс легко викликати з команди, тесту, адміністративної перевірки або фонового завдання.
Якщо перерахунок одразу змінює дані, стає складніше зрозуміти масштаб розбіжності до виправлення.
Порівняння до запису дає безпечний режим перевірки
user_id=42stored=18expected=21difference=+3status=DRIFTРежим лише перевірки особливо важливий для великих наборів даних.
Він дозволяє спочатку відповісти на питання: скільки записів пошкоджено, наскільки велика різниця, чи проблема локальна, чи системна.
Це значно безпечніше, ніж запускати команду, яка одразу переписує тисячі рядків.
Команда відновлення повинна мати явний режим запису
php artisan app:repair-unread-counts # check only php artisan app:repair-unread-counts --write # apply repairТиповий запуск без параметрів може бути лише діагностичним.
Для реального запису потрібен явний прапорець. Це зменшує ризик випадкового масового виправлення під час перевірки.
Відновлення має бути ідемпотентним
Якщо команда вже відновила правильний стан, повторний запуск не повинен створювати нових змін.
Для похідних значень це природна властивість: ми щоразу обчислюємо очікуваний результат із канонічних даних і приводимо збережене значення до нього.
Команда повинна вміти працювати з обмеженою областю
Повний перерахунок усієї системи не завжди потрібен.
Практично корисно мати можливість обмежити перевірку одним користувачем, одним агрегатом, часовим діапазоном, конкретною сутністю або невеликим набором ідентифікаторів.
Це пришвидшує діагностику й зменшує ризик під час точкового виправлення.
Масове відновлення не повинно перетворюватися на одну довгу транзакцію
Для великої таблиці краще працювати пакетами, фіксувати прогрес і не тримати блокування довше, ніж потрібно.
У деяких випадках перед записом варто ще раз прочитати актуальний канонічний стан, щоб не перезаписати зміни, які відбулися під час довгого перерахунку.
Пошуковий індекс - той самий принцип у більшому масштабі
Пошуковий індекс часто повністю відновлюваний з основної бази даних.
Тому поряд із інкрементальним оновленням корисно мати штатний повний перерахунок: побудувати очікувані документи, перевірити відсутні або зайві записи й за потреби переіндексувати їх.
Якщо є лише код "оновити індекс після зміни моделі", але немає способу відтворити весь індекс, система сильніше залежить від того, що жодна подія ніколи не буде пропущена.
Проєкція без шляху відтворення стає прихованим ризиком
Проєкції зручні саме тому, що оптимізують читання. Але оптимізація не повинна робити дані невиправними.
Якщо проєкція будується з подій або основних таблиць, механізм її побудови краще оформити так, щоб його можна було викликати не тільки під час звичайного потоку, а й для повного відтворення.
Команда відновлення не повинна маскувати постійну помилку
Наявність штатного відновлення не означає, що розбіжності можна ігнорувати.
Якщо команда постійно знаходить один і той самий тип розбіжності, треба виправляти причину: втрачену подію, некоректний обробник, стан гонитви, неповну транзакцію або неправильну модель оновлення.
Шлях відновлення потрібен як страховка й інструмент відновлення, а не як регулярна заміна правильної бізнесової логіки.
Результат перевірки теж є корисним сигналом
Якщо порівняння відокремлене від запису, його можна запускати періодично для вибірки або критичних агрегатів.
Так система може помітити розбіжність до того, як її побачить користувач.
Але частота й обсяг такої перевірки повинні відповідати вартості запиту й важливості даних.
Що варто перевірити тестами
1. Correct derived state produces no repair.2. Drift is detected without writing in check-only mode.3. Write mode updates only mismatched records.4. Running repair twice is idempotent.5. Scoped repair does not touch unrelated records.6. Recalculation uses canonical data only.7. Concurrent changes are not overwritten by stale expected state.8. Large repairs can run in batches.9. Repair output reports checked, mismatched, and changed counts.10. A rebuild can recover from a deliberately corrupted derived value.Відновлюваність похідних даних - це властивість архітектури
Лічильник, проєкція або індекс можуть бути дуже зручними, але вони стають безпечнішими, коли система знає, як перевірити їх проти канонічних даних.
Тоді інцидент не починається з написання одноразового скрипта. Уже є перевірений шлях: обчислити очікуване значення, показати різницю, обмежити область і виконати ідемпотентне виправлення.
Якщо дані можна відтворити, здатність їх відтворити варто проєктувати разом із самими похідними даними.
Відновлення похідних даних краще проєктувати тоді, коли система працює правильно, а не тоді, коли вже треба рятувати бойові дані.