
Коли SEO у ICanUp було потрібне тільки для Posts, окремі поля й логіка не здавалися великою проблемою.
Потім з’явилися повноцінні Pages. Далі PostSeries отримали власні публічні сторінки, canonical, hreflang, sitemap, breadcrumbs, обкладинки й окремі SEO metadata.
У цей момент стало зрозуміло: якщо кожен модуль отримає власну таблицю, власний Admin SEO form, власний resolver і власні fallback rules, через кілька місяців у мене буде кілька схожих, але вже різних SEO-систем.
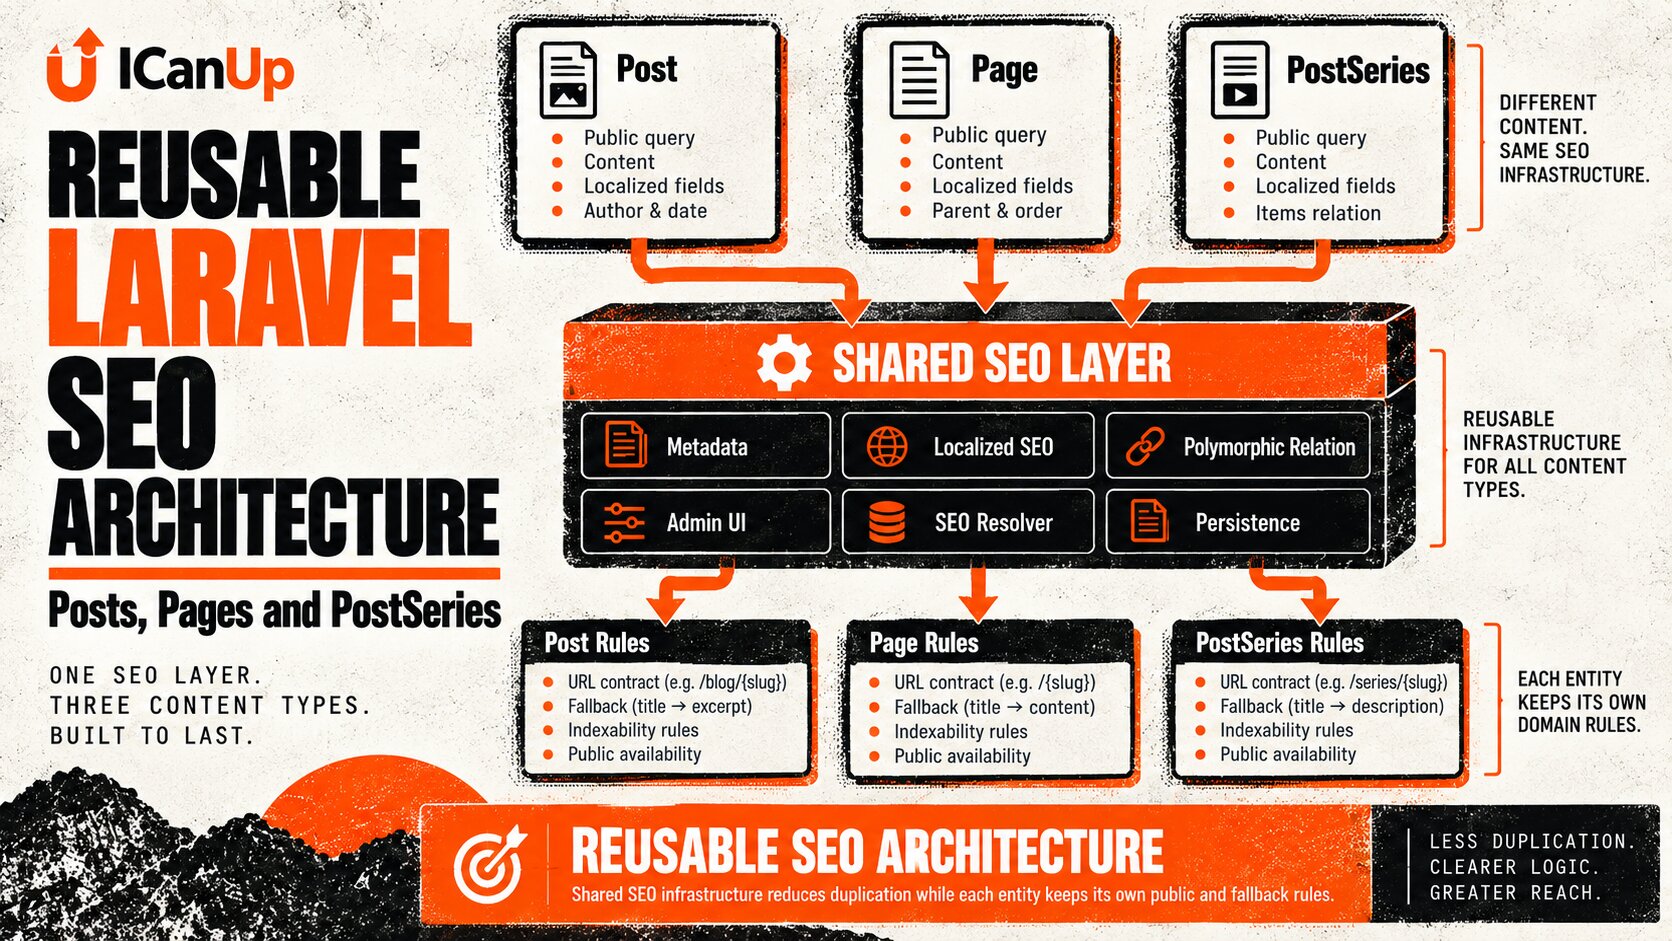
Тому SEO я почала розглядати не як набір полів конкретного Post, а як повторно використовувану інфраструктуру для різних публічних сутностей.
Чому окремий SEO-код у кожній Laravel model швидко стає проблемою
Post SEO fields SEO validation SEO form SEO fallback OG resolver Page SEO fields SEO validation SEO form SEO fallback OG resolver PostSeries SEO fieldsПроблема тут не тільки в кількості коду.
Небезпечніше те, що одна реалізація починає випереджати інші.
- Post уже підтримує новий Open Graph fallback, а Page ще ні.
- Page має правильний localized description, а PostSeries використовує стару логіку.
- Одна форма має character guidance, інша приймає ті самі поля без однакової validation.
- Один модуль правильно обробляє порожній SEO title, інший повертає пустий
<title>. - Після зміни social image contract потрібно виправляти кілька незалежних місць.
Дублювання SEO небезпечне не тоді, коли код однаковий. Воно стає небезпечним після першої зміни, яку внесли тільки в одну копію.
Reusable SEO layer: що варто зробити спільним
Спільна частина | Відповідальність |
|---|---|
Persistence | Зберігати SEO metadata для різних сутностей |
Localization | Окремі UK/EN SEO values |
Admin block | Один reusable редактор полів |
Validation | Однакові правила для однакових полів |
Resolver | Explicit value -> fallback |
Social metadata | OG/Twitter presentation |
Image resolution | Entity image -> global fallback |
Polymorphic SEO relation дозволяє не створювати окрему таблицю для кожної сутності
На рівні Laravel один природний спосіб виразити таку архітектуру - polymorphic relation.
SEO record належить не тільки Post або тільки Page. Він належить будь-якій сутності, яка підтримує спільний SEO contract.
// Simplified architecture example.// Exact class and relation names may differ in the project. public function seo(): MorphOne{ return $this->morphOne( SeoMetadata::class, 'seoable', );}Polymorphic persistence не повинна зберігати PHP class names як довічний контракт
Якщо polymorphic type зберігається в базі, я не хочу прив’язувати persistence до повного namespace класу.
Перейменування або переміщення моделі не повинно вимагати міграції всіх polymorphic records лише тому, що змінився PHP namespace.
Relation::enforceMorphMap([ 'post' => Post::class, 'page' => Page::class, 'post_series' => PostSeries::class,]);Локалізоване SEO не повинно змішувати UK та EN metadata
Для мультимовного сайту одного SEO record недостатньо, якщо title і description локалізовані.
Українська сторінка має отримати українські metadata, англійська - англійські.
Post / Page / PostSeries | vshared SEO record | +--> uk metadata | +--> en metadataЦе особливо важливо для meta_title, meta_description, Open Graph title/description та alt text social image, якщо він входить до спільного SEO contract.
Reusable SEO Admin block прибирає дублювання у формах Post, Page і PostSeries
Збереження даних - тільки половина задачі.
Якщо кожен Admin form окремо малює однакові поля SEO, дуже швидко починають відрізнятися підказки, validation, locale switching і поведінка помилок.
Тому PostSeries у моєму випадку не отримував окремий Series-specific SEO editor. Він підключив той самий стандартний SEO block, який уже використовувався для інших публічних сутностей.
Post form -------+ |Page form -------+--> Shared SEO block |Series form -----+Shared persistence не означає однаковий SEO fallback для всіх моделей
Це одна з найважливіших меж усієї архітектури.
Спільний SEO layer може знати, як прочитати explicit metadata. Але він не повинен вгадувати, яке доменне поле є правильним fallback для кожної сутності.
Сутність | Приклад fallback |
|---|---|
Post | SEO title -> localized Post title |
Page | SEO title -> localized Page title |
PostSeries | SEO title -> localized Series title |
PostSeries description | SEO description -> localized Series description |
SEO resolver краще будувати як explicit value -> domain fallback -> site fallback
meta title explicit localized SEO title | ventity localized title | vsite fallback if needed social image SEO/entity image | vТака послідовність дає дві корисні властивості.
Редактор може явно перевизначити metadata там, де це потрібно, але нова сторінка не залишається без title або description тільки тому, що SEO block ще не заповнили вручну.
PostSeries cover став частиною того самого social image fallback
Коли PostSeries отримали optional cover через спільну Media architecture, для SEO не знадобилося створювати окреме поле "series social image".
Обкладинка Series може використовуватися як social image, а за її відсутності система переходить до глобального fallback.
Це хороший приклад того, як два reusable layers - Media і SEO - можуть доповнювати один одного без нового Series-specific subsystem.
Canonical URL не варто зберігати як довільне SEO field
У моїй архітектурі canonical тісно пов’язаний із public routing і чинною локаллю.
Post, Page і PostSeries мають власні public routes. Тому canonical краще отримувати з реальної URL infrastructure, а не дозволяти редактору вручну вводити довільний URL, який з часом може розійтися з маршрутом.
entity + locale | vlocalized public route | vabsolute canonical URLДетальніше цей multilingual contract я вже розбирала у статті про canonical та hreflang у Laravel.
hreflang теж є результатом routing contract, а не просто SEO form
Те саме стосується hreflang.
Якщо сутність доступна українською й англійською, SEO layer має отримати правильні localized public URLs, а не зберігати копії URL у metadata.
UK entity URL | +--> hreflang="uk" EN entity URL | +--> hreflang="en" default locale URL | +--> hreflang="x-default"Окремий випадок x-default і default locale я розбирала в окремій статті про x-default.
Open Graph type не може бути однаковим для Post і Page
Ще один приклад межі між shared infrastructure і domain semantics - og:type.
Спільний renderer може вивести Open Graph tags, але значення type залежить від сторінки.
Post:og:type = article Page:og:type = website PostSeries:og:type = websiteSSR робить reusable SEO layer видимим для crawler без JavaScript
У SPA-подібній архітектурі недостатньо правильно сформувати metadata тільки після виконання JavaScript.
SEO resolver має передати дані в той шлях рендерингу, який формує початковий server HTML.
Саме тому я перевіряю meta tags через звичайний HTTP response, а не тільки в DevTools після hydration.
Окремо я вже розбирала цю проблему у матеріалі про meta tags, які були в браузері, але не були в HTML.
SEO metadata і indexability - різні рівні системи
Наявність SEO record не робить сутність автоматично публічною або indexable.
Draft Post може мати заповнений meta title. Це не означає, що він повинен потрапити в sitemap або стати доступним crawler.
Inactive PostSeries так само може мати metadata, але public eligibility залишається окремим доменним правилом.
SEO metadata | X does not decide publication Entity public contract | +--> route accessibility +--> robots behavior +--> sitemap eligibility +--> indexing notificationsRobots noindex не повинен бути єдиним захистом Draft
noindex керує поведінкою пошукового crawler, але не є access control.
Якщо Draft не повинен бути публічним, звичайний користувач повинен отримати відповідну public visibility behavior незалежно від того, який robots tag сформував SEO layer.
Sitemap теж не повинен читати всі SEO-enabled records
Ще одна можлива помилка - побудувати sitemap навколо самого факту існування SEO metadata.
Правильний напрямок протилежний: спочатку сутність проходить свій public/indexable contract, і тільки потім SEO infrastructure генерує URL та metadata для sitemap.
JSON-LD також не варто змішувати в одну універсальну схему
Reusable SEO infrastructure може мати спільний механізм додавання JSON-LD у сторінку.
Але сама Schema.org структура залежить від сутності.
Для Post доречна article-specific structured data. Для Page або PostSeries інша сторінкова семантика може бути правильнішою. BreadcrumbList при цьому можна будувати через окремий спільний breadcrumbs contract.
Практичну реалізацію BreadcrumbList я окремо описувала у статті про Laravel BreadcrumbList JSON-LD.
Reusable не означає generic array із сотнею nullable fields
Є інша крайність: намагатися передбачити в одному SEO record кожне можливе поле для всіх майбутніх сутностей.
У результаті з’являється великий набір nullable columns, значення яких потрібні тільки одному рідкісному типу сторінки.
Я віддаю перевагу спільному стабільному ядру й розширенню contract лише тоді, коли нова можливість справді стає загальною.
PostSeries став хорошою перевіркою reusable SEO architecture
PostSeries був для мене показовим кейсом.
Публічна SEO integration серії вже існувала: localized routes, canonical, hreflang, sitemap і breadcrumbs.
Коли знадобилося додати повноцінний editable SEO block в Admin, правильним рішенням було не створити ще одну систему, а підключити Series до того самого SEO contract, який уже працював для Post і Page.
Якщо для нової сутності потрібно переписати весь SEO pipeline, reusable architecture насправді ще не reusable.
Додавання нового SEO-enabled content type має бути передбачуваним
New public entity | +--> connect shared SEO persistence +--> connect localized SEO form +--> define title/description fallback +--> define public URL +--> define OG type +--> define image fallback +--> define indexability +--> add regression testsТранзакція має зберігати entity і SEO metadata як одну операцію
Коли Admin одночасно змінює основні поля сутності й SEO metadata, я не хочу отримати стан, у якому PostSeries уже оновив title, а SEO save впав посередині.
Тому create/update flow має розглядати ці зміни як одну операцію відповідно до загального service pattern.
DB::transaction(function () use ($entity, $seoData) { $entity->save(); $seoService->sync( $entity, $seoData, );});Які SEO тести потрібні для Post, Page і PostSeries
Сценарій | Очікування |
|---|---|
Explicit SEO title | Перевизначає доменний title |
Порожній SEO title | Працює entity fallback |
UK metadata | Не змішується з EN |
EN metadata | Не змішується з UK |
Canonical | Відповідає localized public route |
hreflang | Містить правильні мовні URL |
Post OG type |
|
Page/Series OG type |
|
Entity cover | Використовується, якщо contract це підтримує |
No image | Працює global fallback |
Draft / inactive | SEO metadata не робить сутність indexable |
SSR | Meta tags є в початковому HTML |
Тести fallback важливіші за happy path із заповненими полями
SEO form майже завжди легко протестувати в сценарії, де всі поля заповнені.
Але реальні регресії частіше з’являються тоді, коли частина metadata порожня.
- SEO title порожній, description заповнений.
- SEO description порожній, title заповнений.
- Немає entity cover.
- Є UK SEO, але EN використовує fallback.
- Metadata існує, але entity ще не public.
- Після зміни title fallback теж оновився.
SEO preview в Admin і реальна public indexability не повинні змішуватися
Можливість адміністратора переглянути Draft через публічний layout корисна для перевірки metadata, ContentBlocks і social preview до публікації.
Але цей доступ не повинен змінювати sitemap, public Search, IndexNow або звичайну доступність URL для гостя.
Preview є способом перевірки майбутньої сторінки, а не способом зробити її indexable раніше часу.
Що я не роблю в reusable Laravel SEO architecture
- Не створюю окрему SEO table або JSON-схему для кожної нової public entity.
- Не дублюю однакові SEO fields вручну в кожному Admin form.
- Не зберігаю canonical URL як довільний текст, якщо URL визначається routing contract.
- Не зберігаю окремі hreflang URLs у metadata.
- Не вважаю SEO record доказом того, що сутність public або indexable.
- Не роблю один універсальний fallback, який ігнорує domain semantics.
- Не створюю окреме social image поле, якщо entity cover уже входить у спільний Media contract.
- Не використовую
noindexяк access control. - Не змушую всі сутності використовувати одну JSON-LD schema.
- Не додаю nullable SEO fields наперед без реального reusable use case.
Checklist для reusable SEO layer у Laravel
- Визначити стабільне спільне ядро SEO metadata.
- Підключати різні сутності через reusable relation або contract.
- Не прив’язувати polymorphic persistence до нестабільних PHP namespaces.
- Зберігати локалізовані SEO values окремо для кожної locale.
- Перевикористовувати один Admin SEO block.
- Перевикористовувати однакові validation rules.
- Мати передбачуваний explicit -> domain -> site fallback.
- Залишати canonical і hreflang пов’язаними з routing infrastructure.
- Дозволяти сутності визначати свій OG type.
- Повторно використовувати entity cover через Media contract.
- Не змішувати metadata persistence з public eligibility.
- Генерувати sitemap тільки з реально indexable сутностей.
- Перевіряти metadata в SSR HTML.
- Тестувати порожні explicit fields і fallback paths.
- Зберігати entity та SEO metadata транзакційно.
Повторно використовувана SEO-архітектура повинна прибирати дублювання технічного механізму, але не стирати доменні відмінності між сторінками.
Висновок: SEO layer має бути спільним, а SEO-рішення залишаються доменними
У ICanUp SEO поступово перестало бути функцією тільки Post.
Pages і PostSeries отримали ті самі базові потреби: локалізовані title та description, Open Graph, social image fallback, canonical, hreflang, sitemap і server-rendered metadata.
Замість того щоб будувати паралельні системи, я залишила спільними persistence, локалізацію, Admin SEO block і базове вирішення metadata. Polymorphic або інша extendable integration дозволяє новим public entities підключатися до цього шару без окремої SEO subsystem.
Але reusable infrastructure не повинна вирішувати все. Post сам визначає свою publication semantics і article metadata. Page має власний URL та fallback. PostSeries має власну назву, description, active state та cover.
Мій головний висновок: повторно використовувати потрібно механізм SEO, а не намагатися зробити всі публічні сутності однаковими.


