
Коли у ICanUp з'явився пошук по Content Blocks, мені знадобилося поле content_blocks.search_text.
Сам data блока містить не тільки текст, який бачить користувач. Там можуть бути URL, варіант відображення, вирівнювання, ідентифікатори медіа та інші технічні параметри.
Для пошуку мені потрібна інша проєкція: тільки текст, який має сенс шукати.
Але найцікавішим питанням виявилося не те, як витягнути цей текст. Потрібно було гарантувати, що після кожної зміни ContentBlock.data, збереженої через Eloquent, значення search_text автоматично приводиться у відповідність до актуальних даних блока.
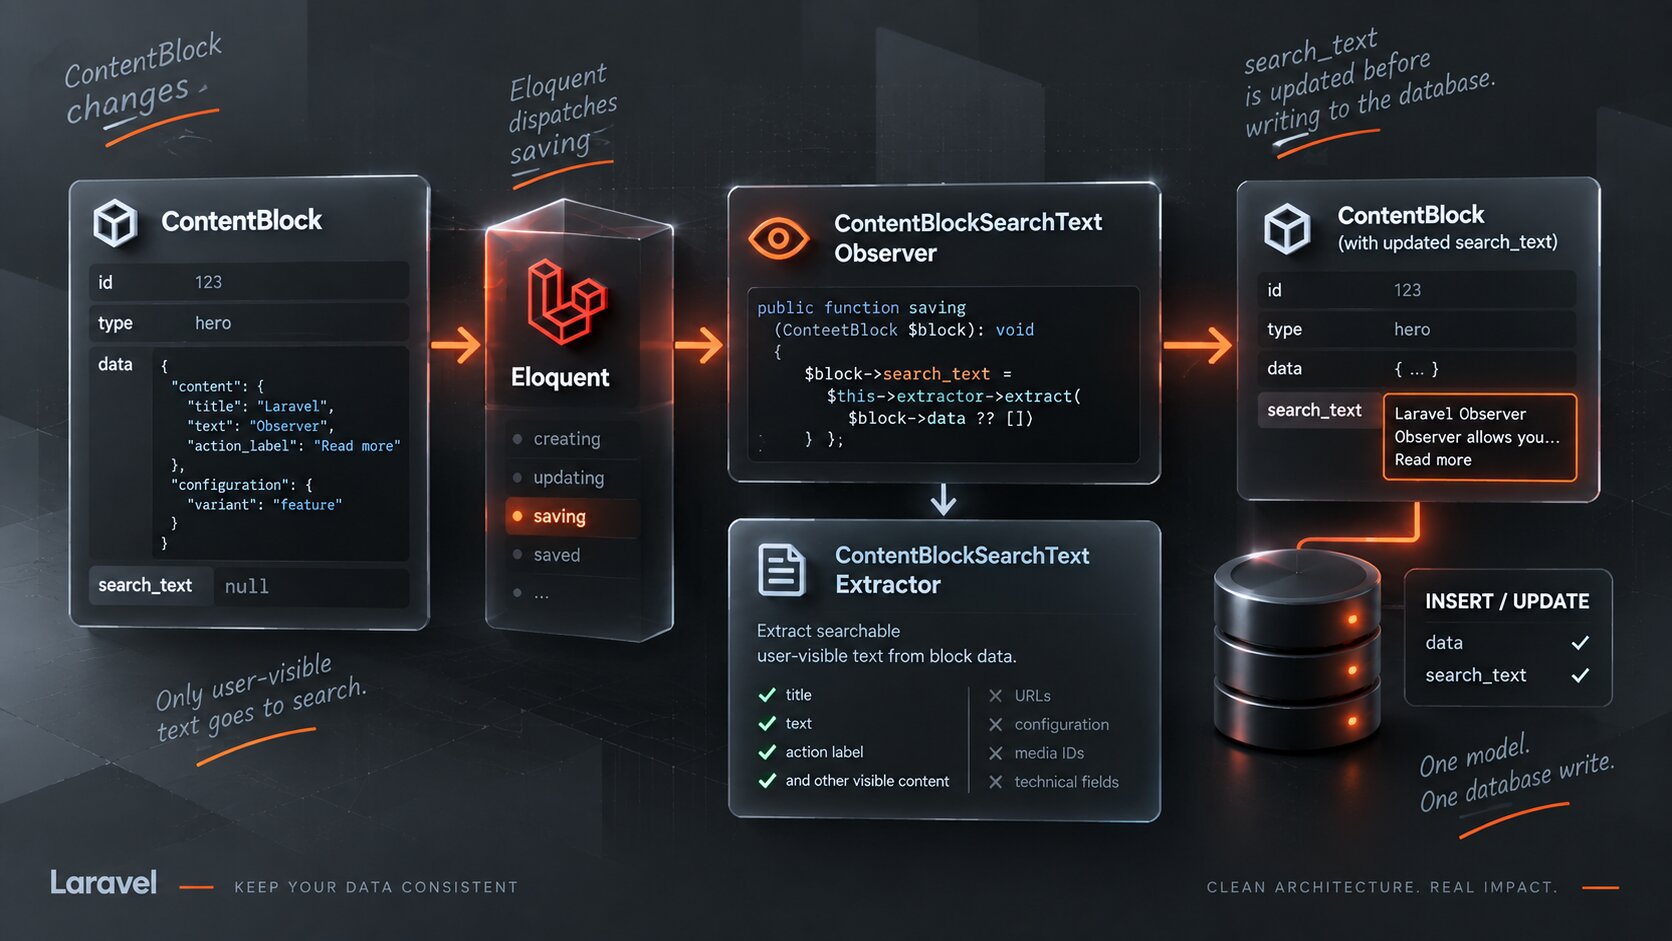
Спочатку потрібно було відокремити дані блока від тексту для пошуку
ContentBlock може містити приблизно таку структуру:
[ 'content' => [ 'title' => 'Laravel Observer', 'text' => 'Observer дозволяє реагувати на події моделі.', 'action_label' => 'Детальніше', 'action_url' => '/articles/observer', ], 'configuration' => [ 'variant' => 'feature', 'alignment' => 'left', ],]Для пошуку мені не потрібні action_url, variant, alignment або інша технічна конфігурація.
Мені потрібен текст, який реально може бачити користувач:
Laravel ObserverObserver дозволяє реагувати на події моделі.ДетальнішеПравило побудови search_text я винесла в окремий клас
Я не хотіла, щоб правила пошуку знали про контролери, процес синхронізації блоків або Observer.
Тому відповідальність за перетворення data у пошуковий текст отримав окремий клас:
final class ContentBlockSearchTextExtractor{ public function extract(array $data): string { // Extract only searchable user-visible text. }}Його контракт дуже простий:
ContentBlock data | vContentBlockSearchTextExtractor | vsearchable user-visible textПерший очевидний варіант був викликати extractor у сервісі
На перший погляд логічно оновлювати поле там, де вже зберігаються Content Blocks:
$contentBlock->search_text = $extractor->extract( $data,); $contentBlock->save();Такий код працює, але створює приховану умову:
search_text залишатиметься правильним лише тоді, коли ContentBlock завжди зберігається через цей конкретний сервіс.
Для мене це занадто слабка гарантія.
Згодом модель може бути змінена з команди, імпорту, адміністративної дії, тестового коду або нового сервісу. Кожне таке місце повинно було б пам’ятати про додаткове поле.
Я хотіла перенести гарантію з caller на життєвий цикл моделі
Замість правила:
When you save ContentBlock,remember to update search_text too.мені потрібне правило:
Whenever ContentBlock is saved through Eloquent,search_text must match data.Це вже природна задача для подій життєвого циклу Eloquent.
Observer реагує на saving незалежно від місця виклику
final readonly class ContentBlockSearchTextObserver{ public function __construct( private ContentBlockSearchTextExtractor $extractor, ) {} public function saving( ContentBlock $contentBlock, ): void { $contentBlock->search_text = $this->extractor->extract( is_array($contentBlock->data) ? $contentBlock->data : [], ); }Тепер мене вже не цікавить, який саме прикладний код ініціював збереження.
Якщо Eloquent проходить подію saving, Observer отримує модель до SQL-запису і формує актуальний search_text.
Це працює і для створення, і для оновлення моделі
Подія saving виконується перед збереженням моделі як під час створення, так і під час наступних змін.
$contentBlock = new ContentBlock();$contentBlock->data = $data;$contentBlock->save();$contentBlock->data = $newData;$contentBlock->save();$contentBlock->update([ 'data' => $newData,]);У всіх цих випадках модель проходить відповідний життєвий цикл Eloquent, тому мені не потрібно вручну дублювати виклик extractor.
Модель не повинна знати, хто за нею спостерігає
У самому ContentBlock немає виклику на кшталт:
$this->searchTextObserver->update();І Observer не керує ContentBlock напряму.
Посередником виступає Eloquent:
ContentBlock changes | vEloquent lifecycle | vsaving event | vContentBlockSearchTextObserver | vContentBlockSearchTextExtractor | vsearch_textObserver реєструється в одному місці
Щоб Laravel знав про цей зв’язок, Observer реєструється під час завантаження модуля ContentBlock.
public function boot(): void{ ContentBlock::observe( ContentBlockSearchTextObserver::class, );}Після цього код, який працює з ContentBlock, не повинен окремо підключати Observer або знати про нього.
Я навмисно не помістила extraction logic у Observer
Можна було б зробити Observer значно більшим і реалізувати всю логіку побудови тексту прямо в ньому.
Але тоді один клас отримав би дві різні відповідальності:
Відповідальність | Де вона живе |
|---|---|
Реагувати на saving |
|
Визначати, який текст є пошуковим |
|
Observer у моєму випадку залишається тонким координатором.
Він знає лише, коли потрібно перерахувати поле. Extractor знає, як його побудувати.
saving тут природніший за saved
Для похідного поля важливий момент виконання.
Подія saving відбувається до запису моделі в базу даних. Тому Observer може змінити search_text, і воно потрапить у той самий INSERT або UPDATE.
data changes | vsaving | vcalculate search_text | vSQL INSERT / UPDATEЯкби я чекала на saved, SQL-запис уже був би завершений.
Для зміни search_text після цього знадобився б ще один запис у базу або спеціальний обхід повторного запуску подій.
save data | vSQL UPDATE | vsaved | vchange search_text | vanother UPDATEsearch_text є похідними даними, а не окремою бізнес-сутністю
Користувач не редагує search_text.
Адмінка не повинна надсилати його як незалежне поле.
Його значення повністю визначається іншим станом:
data | vsearchableProjection(data) | vsearch_textСаме тому автоматичне відновлення цього поля під час життєвого циклу моделі тут добре відповідає самій природі даних.
Observer підтримує майбутні записи, але не виправляє історичні
Коли я додала колонку search_text, у базі вже існували Content Blocks.
Реєстрація Observer не змусить старі записи автоматично пройти через save().
Тому окремо потрібне дозаповнення старих даних.
php artisan app:content-blocks:backfill-search-textBackfill використовує той самий extractor
Я не створюю другу реалізацію правил спеціально для команди.
І під час звичайної роботи застосунку, і під час обробки старих даних використовується той самий ContentBlockSearchTextExtractor.
New and changed data: ContentBlock save | vObserver | vContentBlockSearchTextExtractor Historical data: Backfill command | vObserver підтримує інваріант на майбутнє. Backfill приводить уже існуючі записи до цього інваріанта.
Observer не перехоплює абсолютно будь-яку зміну в базі
Тут є важлива межа, яку я не хочу приховувати.
Eloquent Observer реагує на події моделі. Якщо код обходить життєвий цикл Eloquent, Observer теж може бути обійдений.
Спосіб зміни | Observer |
|---|---|
| Так |
| Так, для конкретного екземпляра моделі |
| Не покладаюся на model events |
| Ні |
Навмисне збереження без подій | Ні |
Тому інваріант формулюю точніше: якщо ContentBlock змінюється через нормальний життєвий цикл Eloquent, Observer синхронізує search_text.
Код, який навмисно обходить модельні події, повинен сам усвідомлювати цю відповідальність.
Це ще одна причина не робити масові update бездумно
Запит на кшталт такого може бути швидким:
ContentBlock::query() ->where(...) ->update([ 'data' => $newData, ]);Але якщо правильність search_text залежить від модельної події, такий шлях повинен бути або заборонений для зміни data, або мати власне явне оновлення похідного поля.
Observer зменшує кількість місць, де потрібно пам’ятати про інваріант, але не скасовує необхідність розуміти межі Eloquent.
Чому я не поклала цю логіку прямо в модель
Можна було б зробити метод ContentBlock, який сам викликає extractor перед кожним збереженням. Але тоді модель почала б напряму знати про сервіс побудови пошукової проєкції.
Observer дозволяє залишити ContentBlock незалежним від конкретного спостерігача, а залежність ContentBlockSearchTextExtractor нормально отримати через контейнер Laravel.
Де Observer працює добре, а де я б його не використовувала
Цей випадок добре підходить для Observer, тому що дія коротка, детермінована і підтримує консистентність самої моделі.
Але я не хочу перетворювати кожне save() на прихований запуск половини системи.
Дія після зміни моделі | Мій підхід |
|---|---|
Оновити похідний search_text | Добрий кандидат для Observer |
Нормалізувати локальний похідний атрибут | Може бути добрим кандидатом |
Надіслати email | Краще явна прикладна подія або задача |
Викликати зовнішній API | Краще явний процес із контролем помилок |
Перебудувати всю систему пошуку | Не хочу приховувати це за звичайним save() |
Опублікувати матеріал у сторонніх сервісах | Окремий явний процес |
Observer прибрав необхідність пам’ятати про search_text
Для мене це найбільша користь рішення.
Без Observer кожен новий код, який працює з ContentBlock, мав би знати ще одне правило:
Changed data?Do not forget to rebuild search_text.Після перенесення цього правила в життєвий цикл про нього не повинні пам’ятати контролер, сервіс синхронізації, команда, імпорт або майбутня адміністративна дія.
Вони змінюють ContentBlock через нормальний Eloquent lifecycle. Консистентність похідного поля підтримується окремо.
Тести для такого Observer теж дуже конкретні
Я хочу тестувати не факт існування Observer, а інваріант, який він забезпечує.
- Новий ContentBlock отримує правильний
search_textпід час збереження. - Зміна
dataперераховуєsearch_text. - Технічна конфігурація не потрапляє в пошукову проєкцію.
- Текст, який бачить користувач, потрапляє в
search_text. - Порожнє або некоректне
dataобробляється передбачувано. - Backfill використовує ті самі правила extractor.
- Повторний запуск backfill не повинен псувати вже правильні значення.
Що я не роблю з Observer
- Не дублюю extraction logic у Observer і backfill command.
- Не змушую кожен сервіс вручну оновлювати
search_text. - Не використовую
saved, якщо похідне поле можна записати в тому самому SQL-запиті черезsaving. - Не очікую, що Observer автоматично заповнить старі записи.
- Не вважаю model events гарантією для масових Query Builder updates.
- Не ховаю дорогі зовнішні інтеграції за звичайним
save(). - Не роблю Observer власником правил пошукової проєкції.
Мій короткий checklist для Observer із derived data
- Спочатку визначити інваріант між вихідним і похідним полем.
- Винести саме правило перетворення в окремий детермінований клас.
- Вибрати подію життєвого циклу, яка відповідає моменту зміни.
- Для поля, яке потрібно записати разом із моделлю, розглянути
saving. - Тримати Observer тонким.
- Зареєструвати його централізовано.
- Окремо обробити історичні дані через backfill.
- Використовувати той самий extractor і під час роботи застосунку, і під час backfill.
- Пам’ятати, що масові SQL updates можуть обходити model events.
- Тестувати інваріант, а не лише сам виклик Observer.
Observer потрібен мені не тому, що Laravel має observe(). Він потрібен тоді, коли я хочу перенести відповідальність із усіх можливих місць збереження на життєвий цикл самої сутності.
Висновок
У випадку з ContentBlock у ICanUp Observer вирішив дуже конкретну проблему.
search_text є похідним від data. Тому я не хочу, щоб контролери, команди, імпорти та сервіси окремо пам’ятали про його перерахунок.
ContentBlockSearchTextObserver реагує на saving, а самі правила формування тексту залишаються в ContentBlockSearchTextExtractor. Завдяки цьому похідне поле записується разом із моделлю, а Observer не перетворюється на великий клас із правилами пошуку.
Для вже існуючих Content Blocks використовується окремий backfill із тим самим extractor. А код, який навмисно обходить модельні події, повинен явно враховувати похідне поле.
Найцінніше тут не те, що стало менше рядків коду. Зникло правило, яке кожному наступному розробнику потрібно було б пам’ятати: після зміни ContentBlock не забудь ще оновити search_text.


