
У Media Explorer в ICanUp я звернула увагу на порядок папок із цифровими назвами.
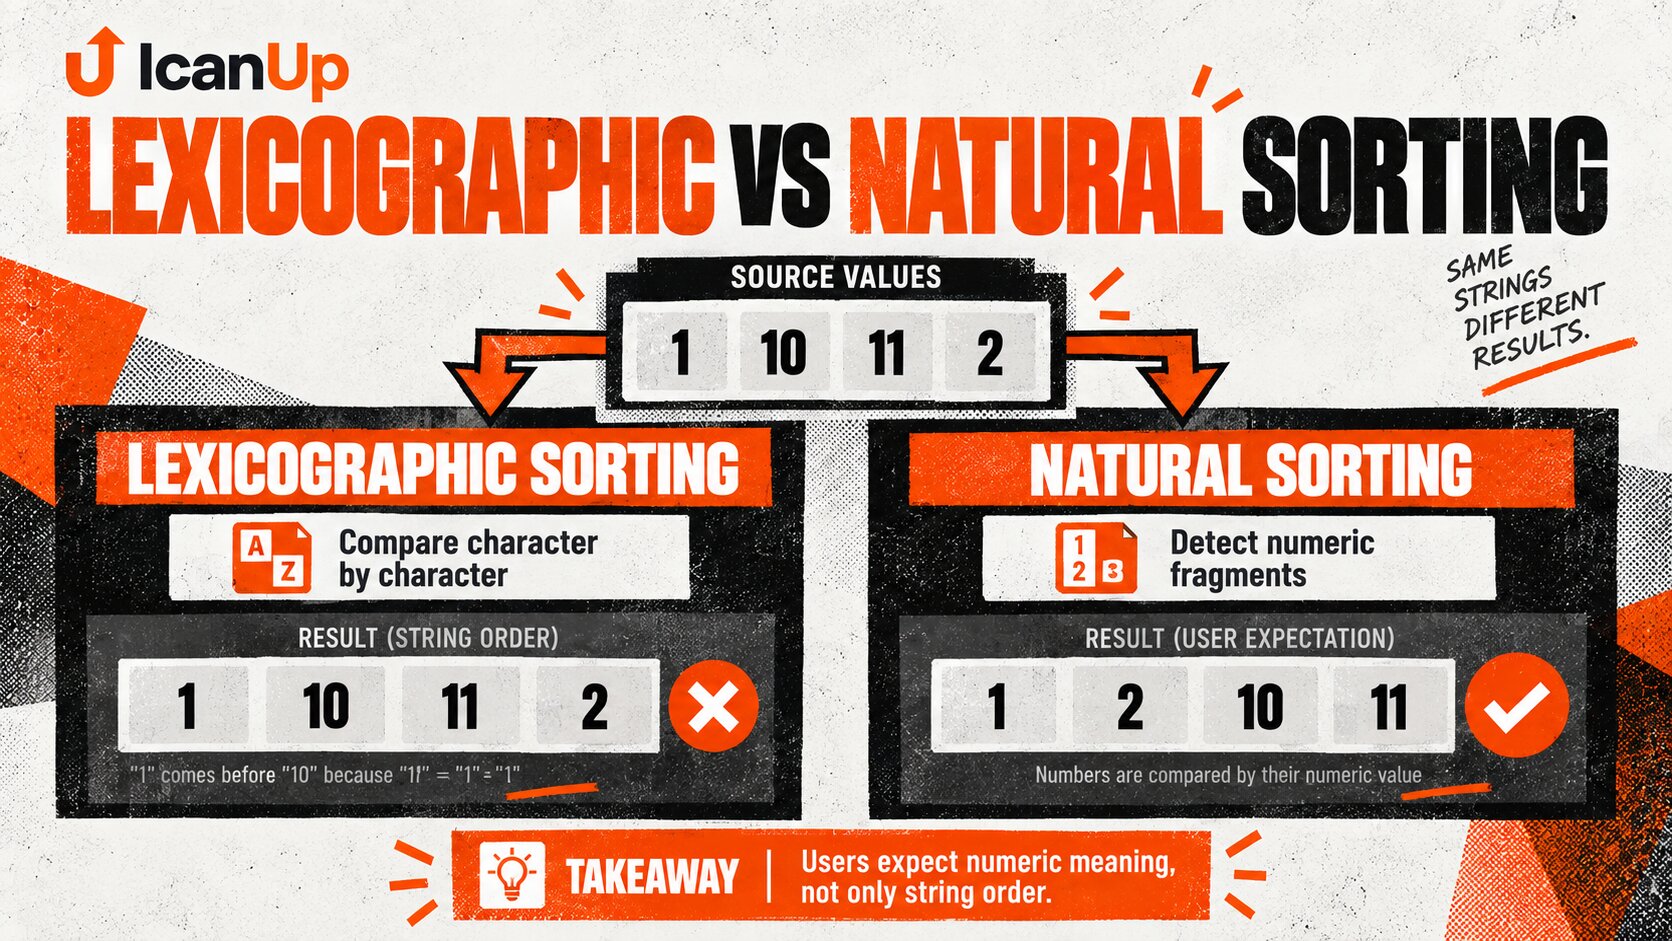
Замість очікуваного 1, 2, 3, 4, 10, 11, 12 інтерфейс показував 1, 10, 11, 12, 13, ..., 19, 2, 3, 4.
На перший погляд це виглядає як очевидна помилка сортування.
Але для звичайного порівняння рядків такий результат цілком закономірний. Проблема не в тому, що компʼютер сортує неправильно. Проблема в тому, що рядковий порядок і порядок, якого очікує людина, не завжди збігаються.
Реальний симптом був дуже простим
У дереві Media Explorer були папки, назви яких складалися з чисел.
Поточний порядок виглядав приблизно так:
1101112131415161718192345...Очікуваний для користувача порядок інший:
12345...10111213...19Чому рядок "10" опиняється перед "2"
Звичайне сортування рядків не перетворює назви на числа.
Воно порівнює символи зліва направо.
"10""2" first character: "1" < "2" therefore: "10" < "2"Тому послідовність 1, 10, 11, 12, 2 не є випадковою.
Для лексикографічного сортування вона логічна.
Баг був не в тому, що рядки сортувалися неправильно. Для цього інтерфейсу був вибраний неправильний тип порівняння.
Natural sorting враховує числові частини
Природне сортування намагається порівнювати назви ближче до того, як їх читає людина.
Числові фрагменти розглядаються як числа.
folder1folder2folder3folder10folder11Замість:
folder1folder10folder11folder2folder3У PHP є готове природне порівняння
Для невеликого набору назв принцип можна показати дуже компактно.
$names = [ '1', '10', '11', '2', '3',]; usort( $names, 'strnatcasecmp',);Після такого порівняння результат відповідає очікуванню користувача:
1231011Чому я дивлюся саме на порівняння без урахування регістру
Назви у Media Explorer не обовʼязково складаються лише з цифр.
Можуть зʼявитися, наприклад:
Archive2archive10Archive11assets1Assets2Якщо регістр не має окремого змісту для користувача, strnatcasecmp() дає природне порівняння без того, щоб великі й малі літери штучно розділяли список.
Для однакових результатів я хочу мати tie-breaker
Навіть після порівняння без урахування регістру можуть зʼявитися назви, які для першого правила рівні.
Наприклад, Assets2 та assets2.
Тоді корисно мати друге, детерміноване правило.
$compareNames = static function ( string $left, string $right,): int { $natural = strnatcasecmp( $left, $right, ); if ($natural !== 0) { return $natural; } return strcmp( $left, $right,Перше правило визначає природний порядок. Друге використовується лише тоді, коли перше не розрізняє значення.
У Media Explorer важливо сортувати самі назви, а не ID
Для користувача порядок визначається тим, що він бачить у дереві.
Database ID не має відповідати порядку назв.
id: 105 name: 2id: 106 name: 10id: 107 name: 1Сортування за id може випадково виглядати правильним на невеликому наборі, але це інший контракт.
Папки й файли не обовʼязково потрібно змішувати
Є ще одне окреме рішення: як поводитися, якщо в одному списку показуються і папки, і файли.
Я не хочу, щоб natural sorting випадково змішало різні типи елементів, якщо Media Explorer концептуально показує папки окремо.
Folders:1210Archive2Archive10 Files:image1.pngimage2.pngimage10.pngТобто тут є два окремі правила:
- спочатку визначити групу елемента;
- всередині групи застосувати природне сортування за видимою назвою.
Одна логіка сортування краща за кілька майже однакових
Media Explorer має кілька місць, де може відображатися дерево або список ресурсів.
Я не хочу, щоб в одному місці порядок був 1, 2, 10, а в іншому знову 1, 10, 2.
Тому правило природного порівняння повинно бути спільним для відповідного набору даних.
final class MediaNameComparator{ public function compare( string $left, string $right, ): int { $natural = strnatcasecmp( $left, $right, ); return $natural !== 0 ? $natural : strcmp($left, $right); }}Сортування після отримання сторінки може дати хибний результат
На невеликому дереві можна отримати весь набір сусідніх папок і відсортувати його в памʼяті.
Але коли список стає великим і зʼявляється пагінація, порядок потрібно визначити до розбиття на сторінки.
Wrong for global ordering: database | vpage 1 | vsort page 1 only Correct contract: database / application ordering | vІнакше кожна сторінка може бути правильно відсортована сама по собі, але весь список залишиться неправильним.
Приклад проблеми з пагінацією
Уявімо, що джерело даних спочатку повертає:
Page 1:11011 Page 2:1223Якщо кожну сторінку відсортувати окремо, отримаємо:
Page 1:11011 Page 2:2312А глобально користувач усе одно побачить 1, 10, 11, 2, 3, 12.
Для тисяч записів змінюється не правило, а місце його виконання
Natural sorting для кількох десятків sibling folders і для десятків тисяч файлів має однаковий UX-контракт, але різні вимоги до реалізації.
Обсяг даних | Практичний підхід |
|---|---|
Невеликий повний список | Можна порівнювати в PHP після завантаження всього набору |
Пагінований список | Порядок потрібно визначити до pagination |
Великий каталог | Варто оцінити sort key або іншу форму сортування на рівні запиту |
Дуже великий каталог | Потрібно врахувати індекси, стабільний порядок і вартість запиту |
Я не хочу завантажувати тисячі записів у PHP лише для того, щоб правильно відсортувати перші 25.
Тому зі зростанням Media Explorer природний порядок повинен стати частиною серверного контракту списку, а не лише косметичною операцією після відповіді API.
Попередньо обчислений sort key може бути одним із варіантів масштабування
Якщо природне сортування стає важливою операцією для великої пагінованої таблиці, одним із можливих напрямів є нормалізований ключ сортування.
name: image2.pngsort key: image0000000002.png name: image10.pngsort key: image0000000010.pngЦе вже окрема оптимізація, а не обовʼязкова частина простого виправлення.
Для мене важливо не ускладнювати систему раніше, ніж цього потребує реальний обсяг даних.
Змішані назви потребують передбачуваного контракту
Реальний список рідко назавжди залишається тільки цифровим.
Поруч можуть зʼявитися:
1210archiveArchive2Archive10draft1draft2draft20Natural comparator добре вирішує числові фрагменти всередині тексту, але продукт усе одно повинен визначити, який загальний порядок вважається правильним.
Наприклад, чи числові папки повинні йти перед текстовими, чи всі назви просто проходять через один natural comparator.
Leading zeros теж варто включити в тести
Ще один цікавий випадок:
10100120210Такі назви можуть мати однакове числове значення, але залишатися різними рядками.
Саме тому я хочу не тільки natural comparison, а й детермінований другий критерій.
Natural sorting не є повною заміною locale-aware sorting
Природне порівняння добре вирішує числа всередині назв.
Але якщо колись Media Explorer повинен буде коректно сортувати великий набір локалізованих назв різними мовами, це вже інша задача.
Тоді потрібно окремо врахувати правила конкретної локалі, а не очікувати, що один natural comparator вирішить усе.
Регресійний тест тут важливіший за сам comparator
Функція порівняння може складатися з кількох рядків.
Але без тесту дуже легко через кілька місяців повернути звичайне сортування під час рефакторингу API або дерева Media Explorer.
$names = [ '1', '10', '11', '2', '3',]; usort( $names, 'strnatcasecmp',); expect($names)->toBe([ '1', '2',Я хочу тестувати не тільки happy path
Сценарій | Що перевіряю |
|---|---|
Тільки цифрові назви |
|
Текст із числами |
|
Різний регістр | Регістр не руйнує natural order |
Змішані numeric/text names | Порядок стабільний і передбачуваний |
Початкові нулі | Однакові числові значення мають deterministic tie-break |
Порожня колекція | Повертається без помилки |
Один елемент | Порядок не змінюється |
Сортування файлів має той самий UX-принцип
Початковий баг у моєму випадку був помітний саме на цифрових назвах папок.
Але той самий принцип легко впізнати у файлах:
image1.pngimage10.pngimage11.pngimage2.pngДля людини очікуваніше:
image1.pngimage2.pngimage10.pngimage11.pngТому після появи спільного правила порівняння його можна використовувати там, де UX справді вимагає такого самого порядку.
Але я не хочу автоматично змінювати всі сортування системи лише тому, що natural sorting добре працює у файловому провіднику.
Сортування повинно належати контракту конкретного списку
Це важлива межа.
Для Media Explorer природне сортування логічне, бо назви папок і файлів читає людина.
Для іншого списку правильним може бути сортування за датою, статусом, пріоритетом або точним рядковим значенням.
Тому я не роблю natural sorting глобальною поведінкою кожного рядкового поля.
Що я не роблю після такого бага
- Не називаю лексикографічне сортування зламаним, якщо воно просто не відповідає UX-контракту.
- Не перетворюю всю назву папки в integer, бо назви можуть бути змішаними.
- Не пишу окремий comparator у кожному компоненті Media Explorer.
- Не сортую тільки поточну сторінку, якщо список має глобальну пагінацію.
- Не використовую database ID як заміну сортуванню за видимою назвою.
- Не ігнорую різний регістр і змішані numeric/text names.
- Не оптимізую тисячі записів складною схемою, якщо поточний набір малий.
- Не застосовую natural sorting до всіх списків застосунку без окремої потреби.
Мій короткий checklist для natural sorting
- Спочатку визначити очікуваний для користувача порядок.
- Відрізнити лексикографічне порівняння від природного.
- Порівнювати видиму назву, а не ID.
- Для чисел усередині тексту використовувати natural comparison.
- Визначити, чи має регістр впливати на порядок.
- Додати deterministic tie-breaker.
- Перевірити цифрові, текстові та змішані назви.
- Окремо перевірити leading zeros.
- Не змішувати папки й файли, якщо UX вимагає окремих груп.
- Тримати одну спільну sorting logic для одного контракту.
- При пагінації визначати глобальний порядок до розбиття на сторінки.
- Закріпити очікуваний порядок регресійними тестами.
Правильне сортування визначається не тим, як легко порівняти два рядки, а тим, який порядок користувач очікує побачити в конкретному списку.
Висновок
Баг із цифровими папками в Media Explorer ICanUp виявився хорошим прикладом того, як технічно правильна поведінка може бути неправильною для інтерфейсу.
Рядкове сортування чесно ставить 10 перед 2, тому що порівнює перші символи. Людина ж читає ці значення як числа і очікує 1, 2, 3, 10, 11.
Natural sorting вирішує цю різницю, а порівняння без урахування регістру допомагає з реальними змішаними назвами.
Але саме сортування є тільки частиною задачі. Якщо список пагінований, порядок потрібно визначати до pagination. Якщо компонент використовується в кількох місцях, правило не повинно дублюватися. Якщо записів стане дуже багато, треба окремо вирішити, де найефективніше формувати цей порядок.
Мій головний урок тут простий: 1, 10, 11, 2 може бути правильним порядком рядків, але файловий провідник створюється не для рядків. Він створюється для людини.


