
Після того як у внутрішній аналітиці ICanUp з’явився поділ Human і Bot, виникло наступне питання: а які саме боти створюють цей трафік?
Один загальний показник Bot уже не давав достатньо інформації. Для SEO важливо відрізняти пошукові роботи, для попереднього перегляду посилань корисно бачити окремі сервіси, а після появи AI-краулерів хотілося розуміти і їхню частку.
Найпростішим рішенням було б зберігати повний User-Agent кожного перегляду й розбирати його пізніше.
Я свідомо пішла іншим шляхом.
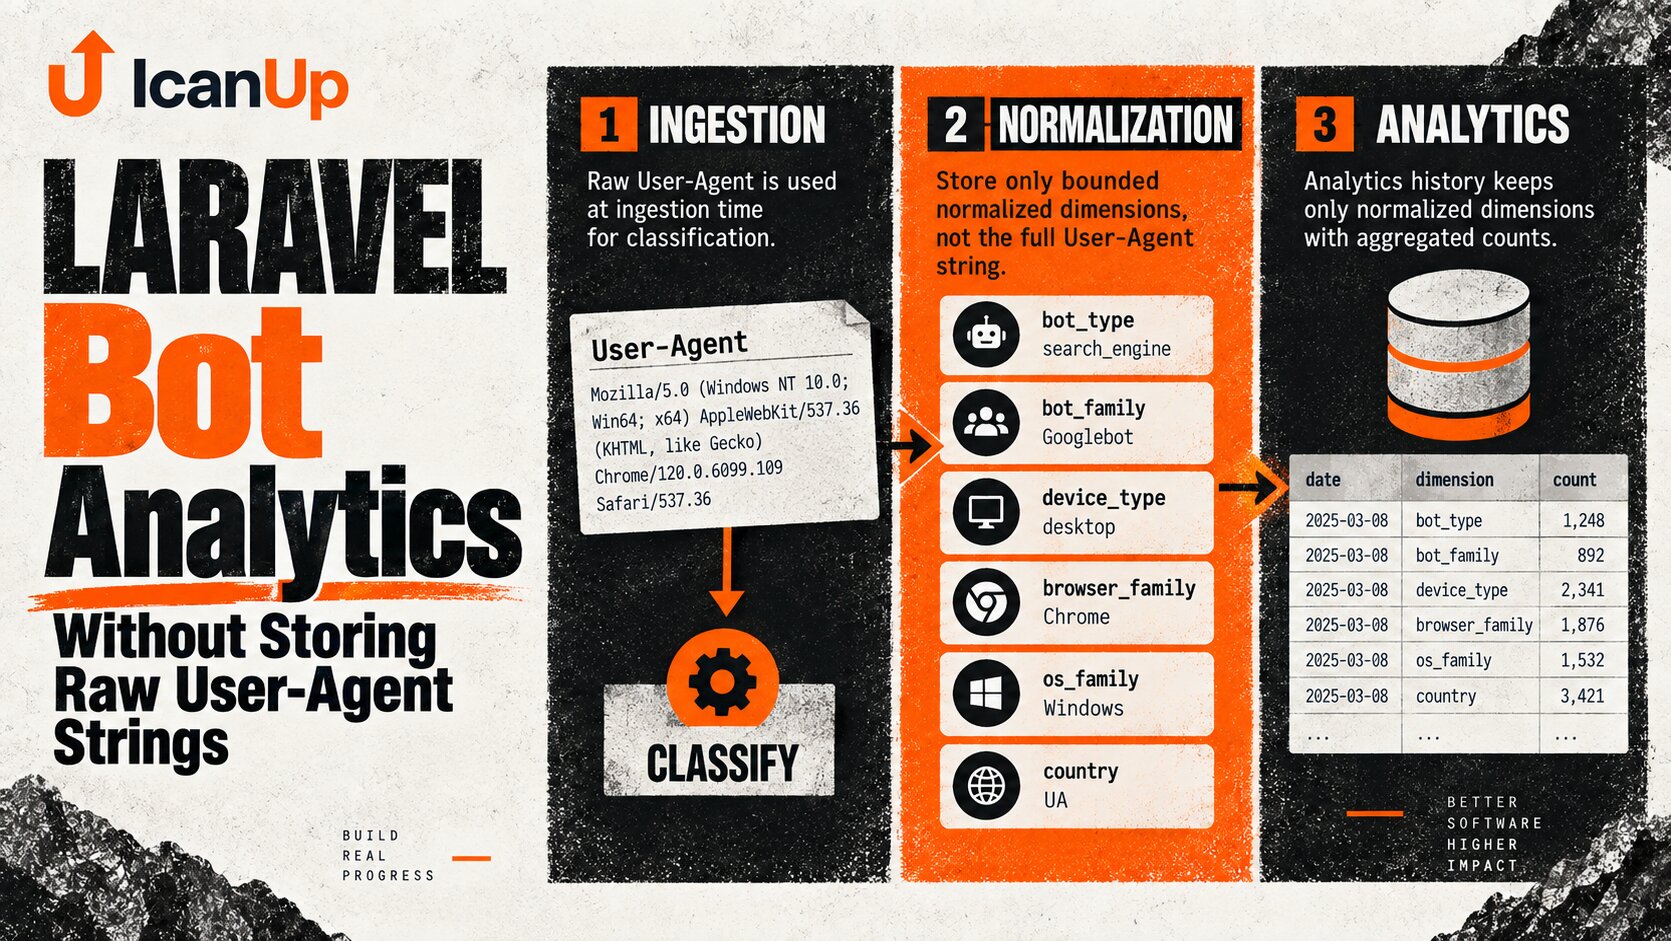
User-Agent корисний на вході, але не обов’язково в історії
Коли HTTP-запит приходить до Laravel, User-Agent містить технічну інформацію про клієнта.
З нього можна спробувати визначити:
- тип пристрою;
- сімейство браузера;
- сімейство операційної системи;
- чи схожий запит на автоматизований;
- чи належить бот до відомого сімейства.
Для цього сире значення справді потрібне.
Але воно потрібне під час обробки запиту. Із цього не випливає, що його потрібно зберігати як аналітичний вимір.
Я розділила отримання сигналу і його збереження
HTTP request | vraw User-Agent | vserver-side classification | +--> device_type +--> browser_family +--> os_family +--> is_bot +--> crawler_family | vstore normalized dimensionsЦе стало базовим правилом для моєї аналітики: сирі дані запиту можуть бути потрібні для визначення ознак, але в історію повинна потрапляти лише інформація, яка справді потрібна для звітів.
Перший рівень дуже простий: Human або Bot
Основним поділом залишається ознака is_bot.
Human request:is_bot = false Automated request:is_bot = trueЦього достатньо, коли я хочу побачити загальну частку людей і автоматизованого трафіку.
Але для аналізу самих ботів одного boolean-поля вже мало.
crawler_family деталізує тільки ботів
Другий рівень класифікації я використовую тільки для запитів, які вже визначені як Bot.
Умовно результат може виглядати так:
is_bot = truecrawler_family = googlebot is_bot = truecrawler_family = bingbot is_bot = truecrawler_family = meta_preview is_bot = truecrawler_family = telegram_preview is_bot = truecrawler_family = ai_crawler is_bot = trueДля людини crawler_family взагалі не потрібен
Human: is_bot = falsecrawler_family = nullЯ не хочу створювати зайві групи на кшталт human усередині crawler_family.
Для цього вже є is_bot. Другий вимір має сенс тільки тоді, коли перший показує Bot.
Чому не варто зберігати повний User-Agent
Повний User-Agent здається привабливим, бо залишає максимум інформації "на майбутнє".
Але для звичайної контентної аналітики це створює кілька проблем.
Сире значення | Нормалізований вимір |
|---|---|
Може мати дуже багато унікальних варіантів | Має обмежений набір значень |
Містить технічні деталі, які не потрібні звіту | Зберігає лише потрібну класифікацію |
Збільшує кількість груп у сховищі | Тримає кількість агрегатів контрольованою |
Збільшує поверхню для профілювання | Краще відповідає мінімізації даних |
Висока кардинальність особливо небезпечна для агрегатів
Моя аналітика зберігає агреговані дані за днем і вимірами.
Кожне нове унікальне значення виміру може створити окрему комбінацію агрегату.
Good: crawler_family- googlebot- bingbot- ai_crawler- other_bot Bad: raw_user_agent- thousands of arbitrary strings- versions- platform fragments- custom scannersЯкщо зберігати повний User-Agent, сховище починає групуватися за деталями, які я все одно не збираюся показувати в основному звіті.
Невідомий бот не повинен створювати нову категорію сам
Особливо важливий випадок - автоматизований клієнт, сигнатура якого не входить до підтримуваного списку.
Я не хочу брати його назву з User-Agent і створювати нове значення аналітики.
Unknown automated client | vis_bot = true | vcrawler_family = other_botТак навіть дивний або спеціально сформований заголовок не розширює словник аналітики довільним значенням.
Сімейство бота не є доказом його справжньої особи
Є ще одна принципова межа.
User-Agent надсилає сам клієнт. Його можна підмінити.
Якщо запит назвав себе Googlebot, це ще не доводить, що він справді належить Google.
User-Agent says:Googlebot Analytics classification:looks like Googlebot Security conclusion:NOT automatically verified GooglebotДля звичайної статистики така класифікація все одно корисна.
Але для розслідування підозрілої активності потрібні інші джерела й окрема перевірка.
Саме тому аналітика й журнали сервера вирішують різні задачі
Коли мені потрібно зрозуміти загальну картину за місяць, достатньо нормалізованих агрегатів.
Коли раптом приходять тисячі підозрілих запитів, уже важливі технічні деталі конкретних HTTP-запитів.
Аналітика | Операційні журнали |
|---|---|
Довготривалі тенденції | Розслідування конкретної події |
Нормалізовані категорії | Точні технічні запити |
Обмежена кількість значень | Може містити детальніший технічний контекст |
Контентні та продуктові питання | Діагностика й безпека |
Я не хочу перетворювати довготривалу контентну аналітику на архів серверних журналів лише тому, що іноді потрібне розслідування.
Браузер, ОС і пристрій я нормалізую за тим самим принципом
Підхід із ботами не є винятком.
Із технічного заголовка запиту я також можу отримати обмежені значення для інших звітів:
{ "device_type": "mobile", "browser_family": "Chrome", "os_family": "Android", "is_bot": false, "crawler_family": null}Для відповіді на питання "скільки переглядів було з Chrome?" мені не потрібна точна версія кожної збірки браузера, якщо вона не має окремої аналітичної цінності.
Raw IP мені теж не потрібна для цієї аналітики
Той самий принцип мінімізації я застосовую до географії.
Для звіту за країнами достатньо нормалізованого дволітерного коду країни, отриманого через довірений інфраструктурний шлях.
Needed for report: country_code = UA Not needed in analytics history: raw client IPНе кожне технічне значення варте нового виміру
Перед додаванням нового поля в аналітику я намагаюся відповісти на три питання.
- Яке конкретне рішення я зможу прийняти за цим показником?
- Чи можна зберегти нормалізовану категорію замість сирого значення?
- Чи не створить новий вимір неконтрольовану кількість комбінацій?
Якщо на перше питання немає відповіді, саме зберігання "про всяк випадок" для мене не є достатньою причиною.
AI crawler теж залишається Bot
Для AI-краулерів я не створюю третій базовий тип відвідувача поруч із Human і Bot.
З погляду основної класифікації це автоматизований трафік.
is_bot = true crawler_family:AI crawler familyЦе дозволяє на верхньому рівні порівнювати Human і Bot, а всередині Bot окремо аналізувати пошукові, AI та інші відомі сімейства.
Відсоток crawler family потрібно рахувати від Bot traffic
Якщо я дивлюся блок сімейств ботів, відсоток має відповідати саме популяції ботів.
All views: 10,000 Human: 8,000Bot: 2,000 Googlebot: 1,000 Googlebot share of bot traffic:1,000 / 2,000 = 50%Якщо поділити 1000 на всі 10000 переглядів, вийде інша метрика й інший зміст.
Фільтри повинні працювати разом
crawler_family корисний не тільки як один загальний список.
Я хочу мати можливість застосувати ті самі часові та контентні фільтри, що й для решти аналітики.
Period:Last 30 days Locale:uk Content:Posts Visitor:Bot Crawler family:GooglebotДля цього не потрібне окреме сховище ботів. Нормалізоване сімейство стає ще одним підтримуваним виміром у спільному механізмі.
Не потрібно створювати окрему таблицю для кожного нового звіту
Я не хочу мати одну таблицю для Googlebot, другу для AI-краулерів і третю для інших ботів.
Класифікація повинна проходити через загальний етап підготовки аналітичних даних перед збереженням.
eligible public request | vanalytics enrichment | +--> locale +--> country +--> device +--> browser +--> OS +--> Human/Bot +--> crawler family +--> traffic source | vshared aggregate persistenceПомилка класифікації не повинна ламати сторінку
Аналітика є допоміжною функцією публічного сайту.
Якщо дивний або пошкоджений User-Agent не вдалося розпізнати, користувач усе одно повинен отримати сторінку.
Для аналітики краще використати передбачуване запасне значення або пропустити необов’язковий вимір, ніж перетворити помилку класифікатора на HTTP 500.
Класифікатор має бути централізованим
Список підтримуваних сімейств не повинен розростатися випадковими перевірками в контролерах.
Концептуально мені потрібна одна точка, яка перетворює сирий сигнал на обмежений результат.
final class CrawlerFamilyResolver{ public function resolve( string $userAgent, bool $isBot, ): ?string { if (! $isBot) { return null; } return $this->knownFamily($userAgent) ?? 'other_bot'; }}Не можна перетворювати назву з User-Agent безпосередньо на значення dimension
// Bad idea:$crawlerFamily = $parsedBotName; // Better contract:$crawlerFamily = match ($knownSignature) { 'google' => 'googlebot', 'bing' => 'bingbot', 'meta_preview' => 'meta_preview', 'telegram_preview' => 'telegram_preview', 'ai' => 'ai_crawler', default => 'other_bot',};У другому варіанті кількість значень визначає застосунок, а не зовнішній клієнт.
Тести повинні перевіряти не тільки відомих ботів
Сценарій | Очікування |
|---|---|
Звичайний браузер |
|
Відомий пошуковий бот | Стабільне нормалізоване сімейство |
Відомий preview bot | Стабільне нормалізоване сімейство |
Підтримуваний AI-краулер | Bot із нормалізованим сімейством |
Невідомий автоматизований клієнт |
|
Порожній або пошкоджений User-Agent | Немає помилки публічної сторінки |
Збережена аналітика | Не містить повного сирого User-Agent |
Окремо тестую приватність самого сховища
Функціональний тест "Googlebot потрапив у правильну групу" для мене недостатній.
Потрібно також перевірити, що сире значення не просочилося в історичний запис.
Persisted analytics may contain: is_botcrawler_familydevice_typebrowser_familyos_familycountry_code Persisted analytics must not contain: full raw User-Agentraw IParbitrary crawler nameOther bot корисний, але має свою межу
Нормалізований other_bot добре захищає сховище від необмеженої кількості значень.
Його недолік очевидний: якщо саме ця група раптом створює більшість трафіку, з агрегованого звіту не видно конкретного джерела.
Але я не хочу вирішувати цю проблему автоматичним довічним збереженням сирих заголовків кожного запиту.
Для аномалії потрібен окремий діагностичний шлях
Коли агрегована аналітика показує аномалію, наприклад різкий ріст other_bot, це вже сигнал для технічної діагностики.
Тоді можна перейти до серверних журналів або іншого контрольованого операційного джерела й дослідити конкретний період.
Analytics: other_bot spike detected | voperational investigation | vinspect detailed server evidence | vdecide whether classifier should changeЯкщо новий бот справді стабільний, корисний для звітів і має надійну сигнатуру, його можна додати до контрольованого класифікатора.
Якщо це одноразовий сканер, аналітика не повинна отримувати нову довготривалу категорію лише через один інцидент.
Мінімізація даних не означає відмову від корисної аналітики
Мені не потрібно вибирати між двома крайнощами: або нічого не знати про трафік, або зберігати кожну технічну деталь запиту.
Між ними є практична модель:
- отримати сирий сигнал під час запиту;
- перетворити його на потрібну категорію;
- зберегти тільки нормалізований результат;
- агрегувати його для звітів;
- детальні технічні розслідування залишити окремому операційному шару.
Що я не зберігаю в основній аналітиці
- Повний сирий
User-Agentкожного перегляду. - Raw IP як аналітичний вимір.
- Довільну назву бота, витягнуту з заголовка.
- Повний URL реферера з довільними параметрами.
- Постійний профіль неавторизованого відвідувача.
- Технічні поля лише тому, що браузер або HTTP-запит дозволяє їх отримати.
Мій короткий checklist для privacy-safe bot analytics
- Визначити, яке бізнесове або технічне питання має вирішувати новий вимір.
- Використовувати сирий User-Agent тільки як вхідний сигнал для класифікації.
- Зберігати Human/Bot як окрему базову ознаку.
- Деталізувати тільки Bot через bounded crawler_family.
- Для Human залишати crawler_family порожнім.
- Не створювати нове значення з довільного тексту User-Agent.
- Невідомих ботів зводити до стабільного fallback.
- Не трактувати User-Agent як підтверджену ідентичність бота.
- Тримати основну аналітику окремо від операційних журналів.
- Не зберігати raw IP лише заради групування трафіку.
- Тестувати не тільки класифікацію, а й відсутність сирих значень у сховищі.
- Контролювати кардинальність кожного нового виміру.
Для аналітики мені потрібне не все, що браузер повідомив про себе. Мені потрібна мінімальна нормалізована інформація, яка відповідає на конкретне питання.
Висновок
У ICanUp я хочу бачити, скільки трафіку створюють люди, скільки боти і які відомі сімейства ботів обходять публічний контент.
Для цього не потрібно зберігати повний User-Agent кожного перегляду.
Сирий заголовок використовується як тимчасовий вхід для класифікації. Після цього в історію потрапляють обмежені значення: is_bot, crawler_family, тип пристрою, сімейство браузера та ОС.
Невідомий бот не створює довільну нову категорію, а потрапляє в передбачуваний fallback. Людина взагалі не отримує crawler_family.
А коли потрібне справжнє розслідування конкретного сканера або підозрілої активності, для цього існують операційні журнали, а не довготривалі контентні агрегати.
Мій головний принцип тут простий: зберігати не максимальну кількість доступних даних, а мінімальну кількість даних, достатню для корисної відповіді.


