Коли власна Analytics у ICanUp почала накопичувати більше даних, я побачила проблему, якої майже не видно на маленьких totals: люди і автоматизований traffic потрапляли в одні й ті самі зрізи.
У результаті великий Direct, певна країна або browser могли виглядати як характеристика реальної аудиторії, хоча частину переглядів створили crawler-и.
Технічно цифри були правильними. Аналітично їх уже було легко прочитати неправильно.
Перший сигнал - Direct уже не означав тільки людей
Traffic Sources і Traffic Channels особливо добре показали проблему.
Якщо crawler приходить без корисного referral context, його перегляд може потрапити в той самий aggregate, який я потім читаю як поведінку людей.
Так само bot traffic може впливати на Countries, Devices, Browsers та Operating Systems.
Змішаний показник | Небезпечна інтерпретація |
|---|---|
Direct | Усі ці перегляди прийшли від людей напряму |
Country | Це географія моєї реальної аудиторії |
Browser | Такі браузери використовують читачі |
Total views | Це обсяг людської уваги |
Я не створювала окрему analytics pipeline для ботів
У tracking уже була canonical ознака is_bot.
Тому окрема таблиця, окремий event store або другий набір aggregates для bot traffic були б зайвими.
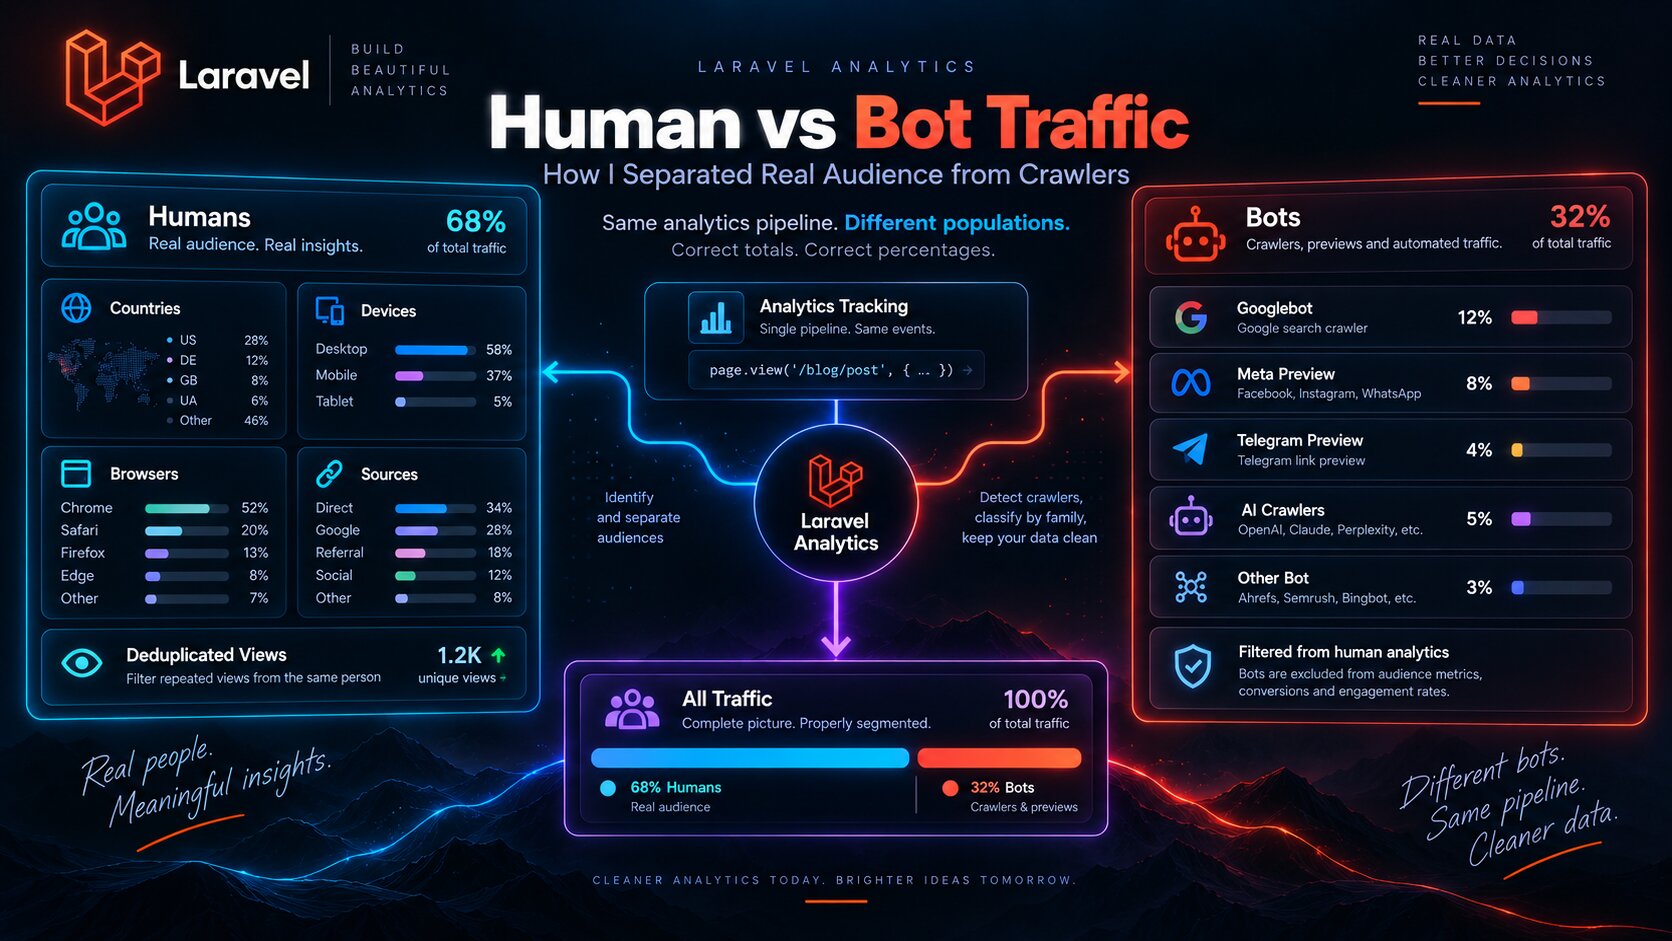
Я залишила одну Analytics pipeline і зробила visitor class ще одним reusable filter.
Existing Analytics data | v is_bot / \ false true | |Humans Bots \ / AllКонтракт став простим: Humans, Bots і All
У application layer для цього з'явився окремий typed visitor-class contract.
Для користувача він виглядає як три зрозумілі режими.
Режим | Population |
|---|---|
Humans |
|
Bots |
|
All | Без visitor-class restriction |
Historical rows, де класифікація ще була недоступна, не потрібно штучно називати Human або Bot.
Вони природно залишаються доступними в All.
Humans став режимом за замовчуванням
Для щоденного аналізу блогу мене насамперед цікавить реальна аудиторія.
Тому default і reset state для visitor-class filter стали Humans, а не All.
All корисний для технічної картини, але він не повинен непомітно бути denominator для audience analysis.
Один filter має змінювати всі пов'язані блоки
Було б недостатньо відфільтрувати тільки загальний counter.
Якщо зверху показані Humans, а Countries або Traffic Sources нижче все ще містять bot rows, dashboard суперечить сам собі.
- Views.
- Deduplicated views.
- Countries.
- Devices.
- Browsers.
- Operating Systems.
- Traffic Channels.
- Traffic Sources.
- Daily data.
- Hourly data.
- Detail і drill-down queries.
Найважливіша деталь - denominator для percentage
Саме тут filter легко реалізувати наполовину.
Уявімо, що за період є 100 переглядів: 60 Human і 40 Bot. Серед Human traffic 30 переглядів припадають на Україну.
У режимі Humans частка України повинна бути 50%, а не 30%.
All:100 views Humans:60 views Human views from Ukraine:30 Correct in Humans mode: 30 / 60 = 50% Wrong: 30 / 100 = 30%Тому після population narrowing я перераховую не тільки rows, а й totals, coverage та percentages.
Deduplicated views теж мають належати активній population
Те саме правило стосується deduplicated views.
Human mode не повинен отримувати deduplicated total, у якому залишилися bot rows.
При цьому я навмисно не називаю цей показник "кількість унікальних людей".
Інші filters не повинні скидатися
Visitor class не існує окремо від решти dashboard.
Коли я перемикаю Humans на Bots, period, locale, page type і content filters повинні залишитися незмінними.
Period: Last 30 daysLocale: ENPage type: PostContent: selected PostVisitor: Humans | | change only Visitor v Period: Last 30 daysLocale: ENPage type: PostContent: selected PostVisitor: BotsVisitor class став частиною query identity
Після додавання filter з'явилася ще одна неочевидна небезпека - cache.
Якщо cache key враховує period і locale, але не visitor class, запит Humans може отримати результат, який раніше був побудований для Bots або All.
Population filter має входити в canonical query/cache identity так само, як інші параметри запиту.
Bad cache identity: analytics:30d:en:posts Better: analytics:30d:en:posts:humansanalytics:30d:en:posts:botsanalytics:30d:en:posts:allHuman vs Bot було тільки першим рівнем
Коли Bots стали окремою population, наступне питання виникло природно: які саме це боти?
Для SEO, indexing і технічного аналізу Googlebot, Telegram preview і AI crawler мають зовсім різний зміст.
Але я не хотіла зберігати raw User-Agent або створювати безмежну кількість dimension values.
Спочатку визначається bot, і тільки потім crawler family
У моїй pipeline існуючий DeviceDetector спочатку визначає canonical is_bot.
Тільки якщо request уже класифікований як bot, окремий resolver намагається визначити bounded crawler family.
Human request ніколи не отримує fake crawler family.
Request | vDeviceDetector | +-- is_bot = false | | | v | crawler_family = null | +-- is_bot = true | v Crawler Family Resolver | v bounded family valueЯ використовую bounded crawler families
Замість повного User-Agent у Analytics зберігається лише невеликий стабільний набір значень.
Family | Що вона представляє |
|---|---|
| Google search crawler |
| Bing crawler |
| Yandex crawler |
| Facebook / Meta preview bots |
| Telegram preview crawler |
| Відомі AI crawler signatures |
| Bot, який не належить до підтриманих families |
AI crawler теж не стає окремою high-cardinality dimension
GPTBot, ChatGPT-User, OAI-SearchBot, ClaudeBot, Claude-Web, anthropic-ai, PerplexityBot і CCBot мають різні User-Agent signatures.
Для мого dashboard мені не потрібно зберігати повний рядок або створювати окрему dimension для кожного варіанта.
Підтримувані стабільні signatures нормалізуються до ai_crawler.
Unknown bot не створює нове довільне значення
Якщо DeviceDetector бачить bot, але family resolver не знаходить підтриману сигнатуру, я не записую шматок User-Agent як нове ім'я.
Такий request переходить у bounded fallback other_bot.
Це тримає cardinality під контролем і не перетворює Analytics на сховище User-Agent strings.
Що я принципово не зберігаю
- Raw User-Agent.
- Повний довільний bot name з User-Agent.
- IP-адресу для bot classification.
- Raw hostname.
- Необмежені crawler values.
- Fake crawler family для Human rows.
Bot crawlers отримали власний denominator
Після появи crawler-family breakdown percentages знову потребують правильного denominator.
Частка Googlebot серед ботів має рахуватися від bot population, а не від усіх Human + Bot views.
Humans:700 views Bots:300 views Googlebot:120 views Correct Googlebot share: 120 / 300 = 40% Not: 120 / 1000 = 12%Historical data я не намагалася вигадати
До появи crawler-family dimension старі bot rows уже існували без цієї інформації.
Я не можу надійно відновити family, якщо raw User-Agent навмисно не зберігався.
Тому historical missing data залишається unavailable, а не отримує вигадану класифікацію.
Чому це змінило моє читання Analytics
Після цього один dashboard став відповідати на два різні набори питань.
Humans | Bots |
|---|---|
Який контент читають люди | Який контент обходять crawler-и |
Звідки приходить аудиторія | Які crawler families активні |
Countries / Devices / Browsers | Search / preview / AI crawler activity |
Human deduplicated views | Bot views і bot-family share |
GeoIP використовує той самий принцип мінімальних dimensions
Той самий принцип я використовую і в інших частинах Analytics: зберігати не сирі мережеві ідентифікатори, а мінімальні bounded dimensions, яких достатньо для реального аналітичного питання.
Що я перевіряла автоматичними тестами
- Humans mode не включає rows з
is_bot=true. - Bots mode не включає Human rows.
- All не застосовує visitor-class restriction.
- Default і reset повертають Humans.
- Percentages використовують denominator активної population.
- Visitor class комбінується з period, locale, page type і content filters.
- Query/cache identity відрізняється між Humans, Bots і All.
- Human request не отримує crawler family.
- Known bot signature отримує стабільну supported family.
- Unknown bot переходить у
other_bot. - Crawler family percentage рахується від bot population.
- Відсутність classification не повинна ламати tracking або public rendering.
Що я б не робила
- Не називала б змішані Views показником реальної аудиторії.
- Не фільтрувала б тільки верхній total, залишаючи breakdowns змішаними.
- Не рахувала б Human percentages від All total.
- Не називала б deduplicated views точною кількістю людей.
- Не створювала б окремий event store для bot traffic.
- Не зберігала б raw User-Agent тільки заради crawler breakdown.
- Не створювала б довільну family з кожного нового bot name.
- Не намагалася б вигадати crawler family для historical rows без даних.
- Не забувала б visitor class у cache key.
Bot traffic не потрібно приховувати. Його потрібно перестати змішувати з питаннями, на які я намагаюся відповісти про реальну аудиторію.
Що я залишила собі на майбутнє
- Human/Bot classification має бути canonical dimension, а не окремою analytics pipeline.
- Default dashboard для audience analysis повинен фокусуватися на Humans.
- Population filter застосовується до totals і breakdowns до розрахунку percentages.
- Deduplicated metrics теж повинні відповідати активній population.
- Filter state входить у query і cache identity.
- Crawler family визначається тільки для request, який уже є bot.
- Families мають бути bounded і стабільними.
- Raw User-Agent та IP не потрібні для crawler-family history.
- Historical missing classification не потрібно вигадувати.
- Human analytics і crawler analytics відповідають на різні питання, навіть коли використовують одну таблицю даних.
Висновок
Спочатку Human і Bot traffic у ICanUp були просто двома значеннями однієї dimension.
Але реальна користь з'явилася тоді, коли visitor class став частиною всього query contract: totals, Countries, Devices, Browsers, Traffic Sources, percentages, daily і hourly data та cache identity.
Після цього Bot population я деталізувала ще на один рівень через bounded crawler families - search crawlers, preview bots, AI crawlers та other_bot - без збереження raw User-Agent.
У результаті одна Laravel Analytics pipeline дає мені дві різні картини: реальну аудиторію і технічний crawler traffic, не змішуючи їхній сенс.