
Коли я почала зберігати історичну аналітику в ICanUp, одна з перших задач виглядала дуже просто: кожен допустимий перегляд має збільшити відповідний лічильник на одиницю.
Поки дивишся на один запит, рішення здається очевидним: прочитати поточне значення, додати 1 у PHP і зберегти результат назад.
Але вебзастосунок не обробляє перегляди строго по одному.
Якщо два запити приходять майже одночасно, проста схема може втратити один із переглядів без жодної помилки.
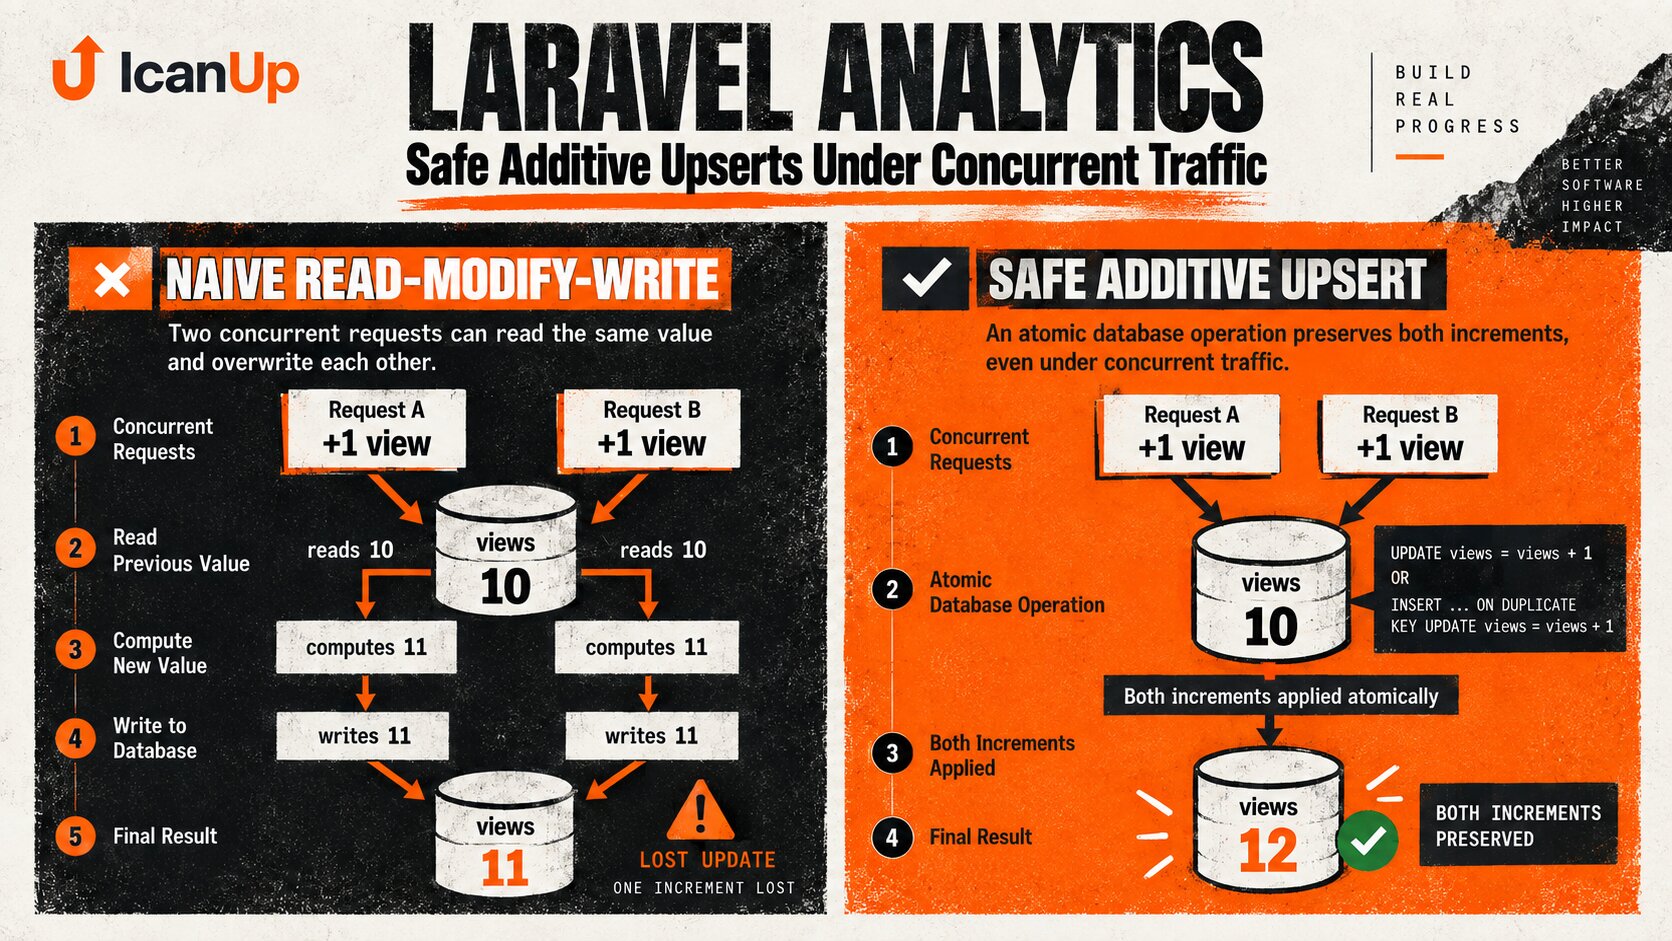
Небезпечна схема виглядає абсолютно нормально
У спрощеному вигляді такий код може виглядати так:
$aggregate = AnalyticsDailyAggregate::query() ->where(...) ->first(); $aggregate->views++; $aggregate->save();Для одного запиту все правильно.
Проблема з’являється, коли два процеси виконують ці кроки одночасно.
Два запити можуть прочитати одне й те саме старе значення
Database: views = 100 Request A reads:100 Request B reads:100 Request A calculates:101 Request B calculates:Фактично було два нові перегляди, тому правильне значення мало стати 102.
Але обидва запити працювали з однією старою копією значення.
Другий запис не додає ще одну одиницю. Він просто повторно записує 101.
Втрачене оновлення небезпечне тим, що система не обов’язково бачить помилку. Вона просто тихо зберігає неправильний результат.
Для лічильника збільшення має виконувати база даних
Для такого сценарію мені потрібна інша властивість: збільшення має відбуватися як атомарна операція над поточним значенням у базі даних.
UPDATE analytics_daily_aggregatesSET views = views + 1WHERE id = ?;Тут PHP не читає 100, щоб потім повернути 101.
База даних сама виконує операцію views = views + 1 над актуальним значенням рядка.
Але потрібний агрегат ще може не існувати
Для добової аналітики є ще одна умова.
Перший перегляд конкретного набору вимірів за сьогодні може не мати готового рядка.
First view today: aggregate row does not exist | vcreate row with views = 1 Next view: aggregate row already exists | vincrease views by 1Тому потрібен контракт "створи рядок, якщо його немає, або атомарно збільш значення, якщо він уже існує".
Саме тут доречна операція типу upsert, але важлива не назва методу, а її атомарність.
Спрощено SQL може виглядати як накопичувальний upsert
INSERT INTO analytics_daily_aggregates ( aggregate_date, metric, subject_type, subject_id, locale, views)VALUES ( ?, ?, ?, ?, ?, 1)ON DUPLICATE KEY UPDATE views = views + 1;Перший запит створює рядок із 1.
Наступні запити не виконують цикл "прочитати -> змінити -> зберегти", а накопичують значення безпосередньо в базі.
Ключова умова - база повинна знати, що означає один агрегат
Атомарна вставка або оновлення працює правильно тільки тоді, коли є однозначне визначення рядка, який потрібно збільшити.
Для добової аналітики один агрегат визначається не тільки датою.
aggregate identity date+ metric+ subject type+ optional subject identity+ locale+ selected dimensionsДва різні виміри не повинні потрапити в один рядок
Наприклад, перегляд української та англійської версії одного Post не повинен випадково накопичуватися в одному локалізованому агрегаті, якщо аналітика має показувати розподіл за мовою.
2026-09-18Post 42locale = ukviews = 20 2026-09-18Post 42locale = enviews = 8Те саме стосується інших підтримуваних вимірів: країни, типу пристрою, браузера, операційної системи, джерела трафіку та інших обмежених значень, які система свідомо зберігає.
Виміри є частиною ідентичності, а не просто додатковим описом
Якщо два запити мають різні набори вимірів, вони повинні збільшувати різні агрегати.
Request A:date = 2026-09-18locale = ukdevice = desktop Request B:date = 2026-09-18locale = ukdevice = mobile Result:two different aggregate bucketsУнікальність у базі захищає контракт
Якщо ідентичність агрегату визначена тільки в PHP, два конкурентні запити все одно можуть одночасно вирішити, що рядка ще немає.
Тому структура бази повинна допомагати гарантувати, що один набір ключових значень не створить два окремі добові рядки.
same aggregate identity Request A -> INSERTRequest B -> INSERT without database uniqueness:two rows may appear with database uniqueness:one identity remains one bucketАтомарність потрібна і для deduplicated views
В аналітиці ICanUp окремо є звичайні перегляди та дедупліковані перегляди.
Дедуплікація визначає, чи потрібно збільшувати другий показник для конкретного запиту.
Але після того, як рішення "збільшити" вже прийняте, саме накопичення також повинно бути безпечним при одночасних записах.
eligible view | +--> views + 1 deduplication says "count" | +--> deduplicated_views + 1Не потрібно блокувати весь процес аналітики
Мета атомарного запису не в тому, щоб обгорнути кожен перегляд великим ручним блокуванням.
Чим коротшою є операція збільшення, тим краще вона підходить для частої події на публічній сторінці.
Я хочу, щоб база даних виконувала мінімальну операцію над конкретним агрегатом.
Добовий агрегат потребує єдиної межі дня
Коли ключ містить дату, виникає ще одне важливе питання: коли саме починається новий день?
Не можна в одному місці брати часову зону PHP-процесу, в іншому часову зону MySQL, а в третьому випадково використовувати UTC.
23:59:59 Europe/Kyiv | v2026-09-18 00:00:00 Europe/Kyiv | v2026-09-19Для моєї аналітики дата агрегату повинна визначатися детерміновано за одним звітним часовим контрактом. У поточній архітектурі це прив’язано до Europe/Kyiv.
Server timezone не повинна випадково визначати аналітику
Сервер може працювати в UTC. Контейнер, черга або окремий процес теж може мати інші налаштування середовища.
Якщо просто викликати "сьогодні" без явного контракту, частина переглядів біля опівночі може потрапити не в той день.
$reportingDate = $occurredAt ->setTimezone( new DateTimeZone('Europe/Kyiv') ) ->format('Y-m-d');Перехід на літній і зимовий час не треба рахувати вручну
Я не хочу зберігати логіку на кшталт "Київ завжди UTC+3".
Часова зона повинна бути іменованою, щоб правила переходу застосовувала стандартна бібліотека часу.
Use:Europe/Kyiv Do not hardcode:UTC+2 foreverUTC+3 foreverЗапис і читання повинні погоджуватися щодо дня
Недостатньо правильно визначити день лише під час запису.
Фільтр "сьогодні", добовий графік і порівняння періодів повинні використовувати той самий часовий контракт.
Tracking:timestamp -> Europe/Kyiv -> aggregate date Admin Analytics:selected period -> Europe/Kyiv day boundaries Both must agreeЧому я зберігаю агрегати, а не кожен сирий перегляд
Для поточної задачі мені не потрібне нескінченне сховище кожного HTTP-запиту.
Основні питання аналітики можна вирішити через накопичені показники за днем і обмеженими вимірами.
Сирі події | Добові агрегати |
|---|---|
Один рядок на кожен перегляд | Один рядок на комбінацію ключових вимірів |
Швидко росте обсяг даних | Обсяг контрольованіший |
Дає детальну історію кожної події | Добре підходить для totals і графіків |
Може зберігати надмірні дані | Легше тримати privacy-safe contract |
Але агрегат збільшує важливість правильного ключа
Коли сирої події немає, неправильний запис не можна просто "перерахувати пізніше" з повної історії.
Тому особливо важливі три речі:
- правильна ідентичність агрегату;
- атомарне збільшення;
- детермінована дата.
Додавання нового виміру змінює кількість агрегатів
Кожен новий вимір розбиває дані на дрібніші групи.
Це корисно, але має ціну.
date+ locale+ country+ device+ browser+ OS+ traffic source+ subject...Тому в аналітику я додаю обмежені, нормалізовані виміри, а не довільні значення з кожного запиту.
Наприклад, для країни достатньо нормалізованого коду країни, а не сирої IP-адреси.
Порожнє значення теж повинно мати один контракт
Якщо певний вимір невідомий, важливо однаково представляти цей стан під час формування ключа.
Інакше логічно однакові запити можуть потрапляти в різні агрегати через різницю між null, порожнім рядком або умовним unknown.
Bad: country = nullcountry = ""country = "unknown" Three representationsof the same semantic stateПовторна спроба запису потребує окремого рішення
Атомарне збільшення захищає від конкурентного перезапису, але не вирішує автоматично всі проблеми.
Якщо той самий логічний перегляд через помилку буде записаний двічі, база чесно збільшить лічильник двічі.
Тому конкурентна безпека та ідемпотентність повторної обробки є різними задачами.
Проблема | Що вирішує |
|---|---|
Два одночасні реальні перегляди | Атомарне накопичення |
Один і той самий перегляд обробили двічі | Потрібний окремий контракт дедуплікації або ідемпотентності |
Кеш не є історичним джерелом аналітики
Ще одне рішення в моїй архітектурі: історичні показники зберігаються в базі даних.
Кеш може допомагати читанню, але очищення кешу не повинно стирати історію переглядів.
Public request | vAnalytics persistence | vDatabase history Cache:optional read optimizationnot historical storageТести повинні створювати саме проблему конкуренції
Звичайний тест "записали два перегляди послідовно й отримали 2" не доводить, що реалізація безпечна при конкуренції.
Корисно окремо перевіряти контракт сховища, унікальність ключа та те, що збільшення не реалізоване через небезпечний цикл читання й повторного збереження.
- перший запис створює новий агрегат;
- наступний запис збільшує той самий агрегат;
- два різні набори вимірів створюють різні агрегати;
- однаковий ключ не створює дубльовані добові рядки;
- звичайні views і deduplicated views накопичуються незалежно;
- перегляди по різні боки межі дня потрапляють у різні дати;
- UK та EN не змішуються, якщо locale входить у виміри;
- видалення кешу не видаляє історичні показники.
Особливо важливо тестувати опівніч
2026-09-18 23:59:59 Europe/Kyiv-> aggregate date 2026-09-18 2026-09-19 00:00:00 Europe/Kyiv-> aggregate date 2026-09-19Такий тест маленький, але захищає весь добовий графік від дуже неприємного зміщення біля опівночі.
Що я не роблю в лічильниках аналітики
- Не читаю поточний views у PHP лише для того, щоб записати views + 1 назад.
- Не покладаюся тільки на перевірку "рядок уже існує?" перед INSERT.
- Не визначаю унікальність агрегату лише в коді застосунку.
- Не використовую випадкову часову зону процесу для добової дати.
- Не змішую різні набори вимірів в один агрегат.
- Не зберігаю довільні необмежені значення як аналітичні виміри без потреби.
- Не називаю deduplicated views точною кількістю унікальних людей.
- Не використовую кеш як єдине історичне сховище.
- Не вважаю атомарний increment автоматичним вирішенням повторної обробки тієї самої події.
Мій короткий checklist для накопичувальної аналітики
- Спочатку визначити точну ідентичність одного агрегату.
- Закріпити цю ідентичність обмеженням у базі даних.
- Не використовувати read -> increment -> save для конкурентного лічильника.
- Збільшувати значення атомарно в базі.
- Підтримати створення нового рядка і збільшення існуючого одним безпечним контрактом.
- Нормалізувати значення вимірів до побудови ключа.
- Мати одну часову зону звітності.
- Однаково визначати межі дня під час запису й читання.
- Окремо розглядати concurrency, дедуплікацію та повторну обробку.
- Тестувати межу дня та різні набори вимірів.
- Зберігати історію в постійному сховищі, а кеш використовувати лише як оптимізацію.
Для лічильника важливо не те, що кожен окремий запит правильно додає одиницю. Важливо, щоб дві одиниці, додані одночасно, ніколи не перетворилися на одну.
Висновок
У добовій аналітиці ICanUp головною проблемою було не саме збільшення views, а гарантія, що одночасні запити не перезапишуть результат один одного.
Схема "прочитати -> додати 1 -> зберегти" працює послідовно, але може тихо втрачати оновлення при конкуренції.
Тому накопичення виконується атомарно на рівні бази даних, а один добовий агрегат визначається стабільним набором ключових значень: датою, метрикою, типом сутності, її ідентичністю та потрібними вимірами.
Не менш важлива дата. Якщо різні частини системи по-різному визначають початок дня, навіть правильні атомарні лічильники дадуть неправильний добовий графік. Тому запис і читання мають використовувати один часовий контракт.
Мій головний висновок: аналітичний лічильник має бути правильним не тільки для одного запиту. Він має залишатися правильним тоді, коли десятки запитів намагаються змінити його одночасно.


